AI EducademyAIEducademy
🌳

AI基礎

🌱
AI Seeds(種)

実社会で役立つAIリテラシー

🌿
AI Sprouts(芽)

インテリジェントシステムを支える基礎

🌳
AI Branches(枝)

今日のAIの実力を活かして作る

🏕️
AI Canopy(樹冠)

信頼できる生成AIシステムを設計する

🌲
AI Forest(森)

責任あるかたちでAIプロダクトを世に出す

🔨

AIマスタリー

✏️
AI Sketch(スケッチ)

AIを作る人のためのエンジニアリング基礎

🪨
AI Chisel(鑿)

より難しい問題を解くためのパターン

⚒️
AI Craft(制作)

AIをスケールさせるシステムを設計する

💎
AI Polish(磨き上げ)

AI時代に伝え、導く

🏆
AI Masterpiece(傑作)

あなたの本番AIキャップストーン

🚀

キャリア準備

🚀
面接ローンチパッド

AIエンジニアリングの求人市場を切り拓く

🌟
行動面接マスター

自分がどう成果を生み出すのかを語る

💻
技術面接

プレッシャーの中で解き、設計し、伝える

🤖
AI・ML面接

最新のMLと生成AIの面接に備える

🏆
オファーとその先

自信を持って、納得のうえで次の一歩を踏み出す

全プログラムを見る→

ラボ

7つの実験がロード済み
🧠ニューラルネットワーク プレイグラウンド🤖AIか人間か?💬プロンプトラボ🎨画像生成😊感情分析ツール💡チャットボットビルダー⚖️倫理シミュレーター
🎯模擬面接ラボへ入る→
ジャーニーブログ
🎯
概要

すべての人にAI教育をアクセス可能にする

❓
よくある質問

よくある質問への回答

🧰
AI ツール

私たちが使い、おすすめする厳選ツール

✉️
お問い合わせ

お気軽にご連絡ください

⭐
オープンソース

GitHubで公開開発

料金
始める
AI EducademyAIEducademy

© 2026 AI Educademy. 無断転載を禁じます。

学ぶ

  • プログラム
  • レッスン
  • ラボ
  • AIスターターキット
  • 料金

コミュニティ

  • GitHub
  • 貢献する
  • 行動規範
  • 概要
  • よくある質問

サポート

  • コーヒーをおごる ☕
  • 利用規約
  • プライバシーポリシー
  • お問い合わせ
  • Sitemap
AI & エンジニアリング プログラム›✏️ AI Sketch(スケッチ)›レッスン›配列とハッシュ マップ - AI がデータを保存および取得する方法
📦
AI Sketch(スケッチ) • 中級⏱️ 15 分で読める

配列とハッシュ マップ - AI がデータを保存および取得する方法

🤖

このレッスンは日本語に自動翻訳されたもので、まだ人によるチェックを受けていません。表現に違和感がある場合は、英語の原文が正となります。

AI においてデータ ストレージが重要な理由

すべての AI システムは、データを迅速に保存および取得する必要があります。画像内のピクセル値のリストであれ、50,000 語の語彙であれ、何百万ものユーザー設定であれ、データ構造の選択によって AI の思考速度が決まります。

配列とハッシュ マップという 2 つの構造が支配的です。これらをマスターすれば、ほぼすべての AI パイプラインの基礎が得られます。

配列 - 即時にアクセスできる順序付きリスト

配列は、メモリ内に並べて保存される項目の番号付きリストです。各項目には インデックス があり、リスト内での位置はゼロから始まります。

index:   0       1       2       3       4
value: ["cat", "dog", "bird", "fish", "frog"]

アイテムは隣り合って配置されているため、任意の位置に直接ジャンプできます。アイテム 3 が欲しいですか?完了 - 検索は必要ありません。これは O(1) アクセスです。つまり、配列に 10 項目が保持されようと、1,000 万個の項目が保持されようと、所要時間は同じになります。
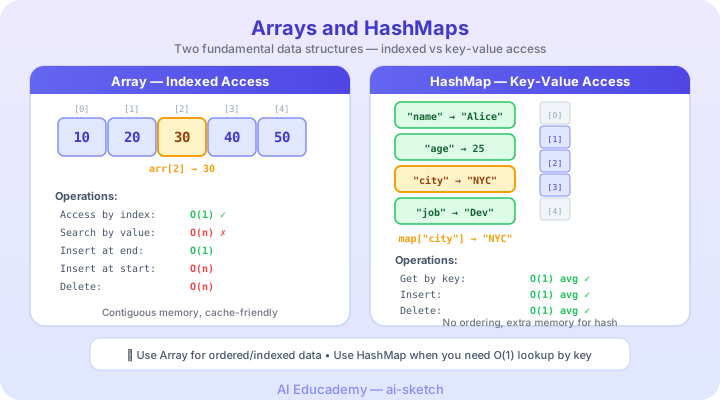
インデックス 0 ~ 4 を持つ 5 つの要素の配列。インデックス 3 への直接アクセスを示します。
配列を使用すると、そのインデックスを使用して任意の位置に直接ジャンプできます。

配列が輝くとき

  • 特徴ベクトル: 画像は、それぞれが輝度値を保持する 784 個の数値 (28×28 ピクセル) の配列として表すことができます。
  • 埋め込み: 言語モデルは、単語の意味を数百の浮動小数点数の配列として保存します。
  • バッチ処理: GPU が数千のサンプルを同時に処理できるように、トレーニング データが配列にロードされます。

キャッチ

途中でアイテムを挿入または削除すると、コストがかかります。変更後のすべての項目は一緒にシャッフルする必要があります。これは O(n) です。項目が多いほど、時間がかかります。

🤔
Think about it:

10,000 曲のプレイリストがあり、位置 5 に新しいトラックを挿入したい場合、位置 5 以降のすべての曲をシフトする必要があります。ストリーミング サービスは速度を落とさずにこれにどのように対処できるでしょうか?

ハッシュ マップ - 名前による即時検索

ハッシュ マップ (ディクショナリまたはハッシュ テーブルとも呼ばれます) は、データを キーと値のペア として保存します。インデックス番号で項目にアクセスするのではなく、意味のあるキーで項目にアクセスします。

word_counts = {
  "hello": 42,
  "world": 37,
  "AI": 156
}

「AI」のカウントが必要ですか?ハッシュ マップは ハッシュ関数 を使用して、バックグラウンドでキーをインデックスに変換します。結果? O(1) 平均検索時間 - 配列と同様ですが、数値の代わりに名前を使用します。

🤯

Python の辞書はハッシュ マップです。 ChatGPT はトレーニング中に単語の出現頻度をカウントする際、ハッシュ マップのような構造を使用して、インターネットのテキスト全体にわたる数十億の単語の出現を追跡します。

実際の AI によるハッシュ マップの使用法

  • 語彙マッピング: 「brilliant」のような単語を言語モデルのトークン ID 8921 に変換します。
  • 頻度カウント: データセット内に各単語がどのくらいの頻度で出現しますか?ハッシュ マップはこれに 1 回のパスで答えます。
  • : AI が入力 X の予測をすでに計算している場合は、再計算できないように保存します。
10のレッスン10%完了
←プログラムに戻る
続ける: 文字列とテキスト処理 - AI がテキストをどのように読み取って理解するか→

ディスカッション

サインイン してディスカッションに参加

このレッスンの修正を提案する
結果のキャッシュ

時間の複雑さをシンプルに

|操作 |配列 |ハッシュマップ | |----------|----------|----------| |インデックスによるアクセス | O(1) ⚡ |該当なし | |キーによるアクセス |お(ん)🐢 | O(1) ⚡ | |最後に挿入 | O(1) ⚡ | O(1) ⚡ | |真ん中に挿入 |お(ん)🐢 |該当なし | |値の検索 |お(ん)🐢 | O(1) ⚡ |

O(1) は「サイズに関係なく即時」、O(n) は「データが大きくなるほど遅くなる」と考えてください。

🧠クイックチェック

100,000 のユーザー プロファイルがあり、ユーザー名でユーザーを検索する必要があります。どの構造が最速ですか?

一般的なパターン: 頻度のカウント

インタビューと AI の両方で最も役立つパターンの 1 つは、発生回数をカウントすることです。疑似コードのアイデアは次のとおりです。

counts = {}
for each word in text:
    if word in counts:
        counts[word] = counts[word] + 1
    else:
        counts[word] = 1

テキストをこの 1 回通過するだけで、すべての単語の頻度がわかります。言語モデルは、まさにこのアプローチを (大規模に) 使用して、どの単語が最も重要かを理解します。

よくあるパターン: 2 つの和の問題

数値の配列と目標が与えられた場合、その合計が目標に達する 2 つの数値を見つけます。単純なアプローチでは、すべてのペア - O(n²) をチェックします。賢いアプローチでは、ハッシュ マップを使用します。

seen = {}
for each number in array:
    complement = target - number
    if complement in seen:
        return [seen[complement], current_index]
    seen[number] = current_index

1 回のパス、O(n) 時間。ハッシュ マップは、すでに見たものを記憶しています。

🧠クイックチェック

2 和へのハッシュ マップ アプローチが、すべてのペアをチェックするよりも速いのはなぜですか?

いつどれを選択するか

  • 配列を使用します 順序が重要な場合、位置によって項目にアクセスする場合、またはすべてを順番に処理する必要がある場合 (画像内のピクセルなど)。
  • ハッシュ マップを使用しますは、キーによる高速検索が必要な場合、出現回数をカウントしたい場合、または何かが存在するかどうかを迅速に確認する必要がある場合に使用します。
🤔
Think about it:

レコメンデーション エンジンは、映画を提案する前に、ユーザーがその映画をすでに視聴したかどうかを確認する必要があります。ユーザーの視聴履歴を配列またはハッシュ マップに保存しますか?どのようなトレードオフが思い浮かびますか?

🧠クイックチェック

AI モデルは、単語の埋め込みをそれぞれ 300 個の数値の配列として保存します。ここで配列が適切な選択となるのはなぜでしょうか?

重要なポイント

  • 配列 はインデックスによる O(1) アクセスを提供し、数値 AI (画像、埋め込み、テンソル) のバックボーンです。
  • ハッシュ マップ は、キーによる O(1) アクセスを提供し、検索、カウント、キャッシュに不可欠です。
  • 適切な構造を選択すると、O(n²) アルゴリズムを O(n) アルゴリズムに変えることができます。この違いは、数百万のデータ ポイントを処理する場合に重要です。
  • 実際には、ほとんどの AI パイプラインは、数値計算用の配列とメタデータ ルックアップ用のハッシュ マップの両方を使用します。

次のステップ

これで AI のデータ処理を支える 2 つの基本構造を身につけました。次の 文字列とテキスト処理 では、AI が生のテキストをモデルが実際に読める形に変える方法を学びます。これは、あなたが使うすべてのチャットボットや検索ボックスの裏にある最初のステップです。