AI EducademyAIEducademy
🌳

AI基礎

🌱
AI Seeds(種)

実社会で役立つAIリテラシー

🌿
AI Sprouts(芽)

インテリジェントシステムを支える基礎

🌳
AI Branches(枝)

今日のAIの実力を活かして作る

🏕️
AI Canopy(樹冠)

信頼できる生成AIシステムを設計する

🌲
AI Forest(森)

責任あるかたちでAIプロダクトを世に出す

🔨

AIマスタリー

✏️
AI Sketch(スケッチ)

AIを作る人のためのエンジニアリング基礎

🪨
AI Chisel(鑿)

より難しい問題を解くためのパターン

⚒️
AI Craft(制作)

AIをスケールさせるシステムを設計する

💎
AI Polish(磨き上げ)

AI時代に伝え、導く

🏆
AI Masterpiece(傑作)

あなたの本番AIキャップストーン

🚀

キャリア準備

🚀
面接ローンチパッド

AIエンジニアリングの求人市場を切り拓く

🌟
行動面接マスター

自分がどう成果を生み出すのかを語る

💻
技術面接

プレッシャーの中で解き、設計し、伝える

🤖
AI・ML面接

最新のMLと生成AIの面接に備える

🏆
オファーとその先

自信を持って、納得のうえで次の一歩を踏み出す

全プログラムを見る→

ラボ

7つの実験がロード済み
🧠ニューラルネットワーク プレイグラウンド🤖AIか人間か?💬プロンプトラボ🎨画像生成😊感情分析ツール💡チャットボットビルダー⚖️倫理シミュレーター
🎯模擬面接ラボへ入る→
ジャーニーブログ
🎯
概要

すべての人にAI教育をアクセス可能にする

❓
よくある質問

よくある質問への回答

🧰
AI ツール

私たちが使い、おすすめする厳選ツール

✉️
お問い合わせ

お気軽にご連絡ください

⭐
オープンソース

GitHubで公開開発

料金
始める
AI EducademyAIEducademy

© 2026 AI Educademy. 無断転載を禁じます。

学ぶ

  • プログラム
  • レッスン
  • ラボ
  • AIスターターキット
  • 料金

コミュニティ

  • GitHub
  • 貢献する
  • 行動規範
  • 概要
  • よくある質問

サポート

  • コーヒーをおごる ☕
  • 利用規約
  • プライバシーポリシー
  • お問い合わせ
  • Sitemap
AI & エンジニアリング プログラム›🌲 AI Forest(森)›レッスン›AI 製品の構築 - プロトタイプから生産まで
🚀
AI Forest(森) • 上級⏱️ 20 分で読める

AI 製品の構築 - プロトタイプから生産まで

🤖

このレッスンは日本語に自動翻訳されたもので、まだ人によるチェックを受けていません。表現に違和感がある場合は、英語の原文が正となります。

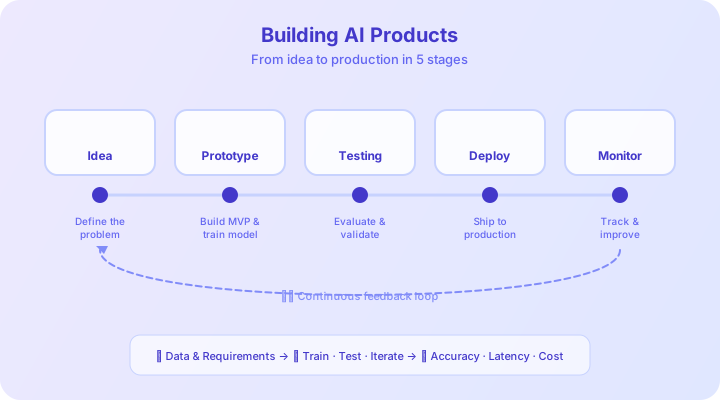
AI 製品の構築

ほとんどの AI プロジェクトは本番環境に移行することはありません。実用的なノートブックと信頼性の高い製品との間には、インフラストラクチャ、モニタリング、チーム プロセス、コスト管理に至るまで、大きなギャップがあります。このレッスンでは、そのギャップをうまく埋めるために必要なすべてを取り上げます。

AI は正しいソリューションですか?

コードを 1 行書く前に、AI 製品開発で最も重要な質問をしてください。それは、この問題に AI が実際に必要かどうかということです。答えは「ノー」であることが思っているよりも多いです。

AI は次の場合に適切な選択です。

  • 問題には大規模なパターン認識 (不正検出、画像分類) が含まれます。
  • ルールが複雑または多すぎて手動でエンコードできない
  • データは入手可能で、高品質で、現実世界の状況を表しています。
  • 確率的な回答 (信頼度 90%) が許容されます。
  • 自動化の価値は、システムの構築と保守のコストを大幅に上回ります

次の場合、AI は間違った選択です。

  • シンプルなルールまたはヒューリスティックにより問題を確実に解決します
  • 十分なトレーニング データが不足しています
  • 意思決定には、完全な説明可能性を備えた 100% の精度が必要です (一部の規制状況)
  • ML システムのメンテナンスコストが利益を上回ります
💡

10 倍ルール: AI が速度、精度、コストの点で非 AI 代替手段と比較して少なくとも 10 倍の改善を実現しない場合、ML システムを維持する運用の複雑さにはほとんど価値がありません。

適切なモデルの選択

すべての問題に大規模な言語モデルが必要なわけではありません。間違ったモデル タイプの選択は、AI 製品開発において最も高くつく間違いの 1 つです。ツールをタスクに合わせます。

|問題の種類 |ベストアプローチ |例 | |---|---|---| |表形式の予測 |勾配ブースト ツリー (XGBoost、LightGBM) |チャーン予測、価格設定 | |画像タスク | CNN またはビジョン トランスフォーマー |品質検査、OCR | |テキスト分類 |微調整された BERT またはそれより小さい LLM |感情分析、ルーティング | |生成テキスト | LLMs (GPT、Claude、Llama) |チャットボット、コンテンツ生成 | |時系列 | Prophet、N-BEATS、または一時的な CNN |需要予測 |

🧠クイックチェック

50,000 行の構造化データを含む表形式のチャーン予測タスクの場合、通常、どのアプローチが最も効果的ですか?

プロトタイピングを迅速に行う: 3 日間のスプリント

反復の速度は常に完璧を上回ります。前提に基づいて無駄なリソースを検証する前に、構築に何か月も費やすチーム。このフレームワークを使用してアイデアを迅速に検証します。

1 日目 - 範囲とデータ。 重要な単一の指標を定義します。これは交渉の余地のないものであり、明確な成功指標がなければ何も評価できません。実行可能な最小限のデータセットを収集またはシミュレートします。完璧に掃除する必要はありません。使用できる程度に掃除してください。

2 日目 - 構築とテスト。 既存のモデルまたは API を使用します。最小限のインターフェイス (Streamlit、Gradio、または単純な API) でラップします。人間が操作できるものを手に入れましょう。

3 日目 - 検証。 実際のユーザーや関係者の前に置いてください。礼儀正しい同僚ではなく、ソリューションに実際にお金を払ってくれる人々です。成功指標に照らして測定します。決定: 殺すか、ピボットするか、投資するか。

🤔
Think about it:

あなたが最後に取り組んだ AI プロジェクトについて考えてください。最初のバージョンがユーザーの前に届くまでにどれくらい時間がかかりましたか? 3 日間のスプリントで核となるアイデアをもっと早く検証できたでしょうか?

MLOps の要点

本番環境 ML には、ほとんどのデータ サイエンティストが学術環境で学んだことのない厳格な運用慣行が必要です。中核となる原則は一見単純です: すべてをバージョン化し、すべてを自動化する。ただし、実行には規律と適切なツールが必要です。

10のレッスン10%完了
←プログラムに戻る
続ける: オープンソース AI エコシステム - ツール、モデル、コミュニティ→

ディスカッション

サインイン してディスカッションに参加

このレッスンの修正を提案する
バージョンの対象:
  • コード - 標準の Git ワークフロー
  • データ - DVC、Delta Lake、または同様のツールを使用してデータセットのバージョンを追跡します
  • モデル - メタデータ (ハイパーパラメーター、トレーニング データ ハッシュ、評価メトリクス、系統) を含むモデル アーティファクトを保存します。
  • 構成 - 環境変数、機能フラグ、モデル パラメーター、およびサービス構成

パイプラインの自動化:

  • スケジュールまたはデータドリフト検出に基づいて再トレーニングをトリガーします
  • 保持されたテストセットに対する評価を自動化します
  • パフォーマンスのしきい値に基づいてデプロイメントをゲートする
  • モデルのロールアウトには Blue-Green または Canary デプロイメントを使用します
🤯

Google の調査によると、実際の ML システム コードの実際のモデルはわずか約 5% であることがわかりました。残りの 95% はデータ パイプライン、サービス インフラストラクチャ、監視、構成管理です。

データ、トレーニング、展開、監視の各段階を示す MLOps ライフサイクル
MLOps ライフサイクル - 1 回限りの導入ではなく継続的な改善

モニタリング: ユーザーが問題を発見する前に問題を発見する

モデルのデプロイはゴールではなく、スタートラインです。適切な監視がなければ、モデルは静かに劣化し、誰かが気づいたときにはすでに損害が発生しています。

データ ドリフト - 入力データの分布は時間の経過とともに変化します。パンデミック前のショッピング データに基づいてトレーニングされたモデルは、パンデミック後のパターンでは失敗します。コルモゴロフ・スミルノフ検定や人口安定度指数などの検定を使用して、特徴分布を継続的に監視し、統計的に有意な変化を警告します。

モデルの劣化 - データ ドリフトがなくても、現実世界の変化に応じてモデルのパフォーマンスが低下する可能性があります。ユーザーの行動は進化し、競合他社は市場を変え、季節のパターンによって結果が変わります。予測の信頼性、エラー率、ビジネス指標を継続的に追跡します。

主要な監視方法:

  • 入力、出力、信頼スコアを含むすべての予測をログに記録します
  • 精度が定義されたしきい値を下回った場合の自動アラートを設定します
  • ローリング ウィンドウでライブ パフォーマンスをベースライン モデルと比較します。
  • エッジケースや信頼性の低い予測に対する人間による定期的なレビューをスケジュールする
  • モデル指標と並行してビジネス指標を追跡します - コンバージョンが低下すると精度は意味を持ちません
🧠クイックチェック

実稼働 ML システムのコンテキストにおける「データ ドリフト」とは何ですか?

コスト最適化戦略

AI 推論コストは急速に上昇する可能性があります。賢明なアーキテクチャの決定により、管理が容易になります。

実践的な戦略:

  1. 複雑さによるルーティング - 単純なクエリには安価で高速なモデルを使用し、必要な場合にのみ高価なモデルにエスカレーションします。これだけでコストを60~80%削減できます。
  2. 積極的にキャッシュする - 同じまたは類似のクエリが繰り返し発生した場合、応答をキャッシュします。セマンティック キャッシュ (正確なテキストではなく、意味によるマッチング) は特に効果的です。
  3. バッチ推論 - オフピーク時に緊急でないリクエストをバッチで処理し、GPU 使用率を最大化します。
  4. 量子化モデル - 4 ビットまたは 8 ビット量子化により、ほとんどのアプリケーションで品質損失を最小限に抑えながらコストを 50 ~ 75% 削減できます。
  5. 適切なサイズのインフラストラクチャ - トレーニングにはスポット インスタンスを使用し、サービスには予約インスタンスを使用し、需要に基づいて自動スケールします。
🧠クイックチェック

クエリの複雑さに基づいてさまざまなモデルを使用するコスト最適化戦略はどれですか?

🤔
Think about it:

AI 推論に月額 10,000 ポンドの予算が与えられた場合、それをどのように割り当てますか?システムのどの部分がバッチ処理と比較してリアルタイム応答を必要とするか、またキャッシュによって冗長な計算を排除できる部分を検討してください。

重要なポイント

AI 製品の構築は、単なる機械学習の問題ではなく、基本的に製品とエンジニアリングの課題です。次の原則を近くに置いてください。

  • 構築する前に AI が本当に適切なソリューションであることを検証する
  • モデルの種類を問題に合わせる - LLM が常に答えになるとは限らない
  • 既存のモデルとシンプルなインターフェースを使用して、数か月ではなく数日でプロトタイプを作成します
  • コード、データ、モデル、構成などすべてをバージョン管理する
  • 本番環境でのデータドリフトとモデルの劣化を継続的に監視します
  • ルーティング、キャッシュ、バッチ処理、量子化を通じてコストを最適化します。

最高の AI 製品は、テクノロジーとビジネスの問題の両方を深く理解しているチームによって構築されます。製品思考のない技術的な卓越性は、誰も使用しない印象的なデモにつながります。