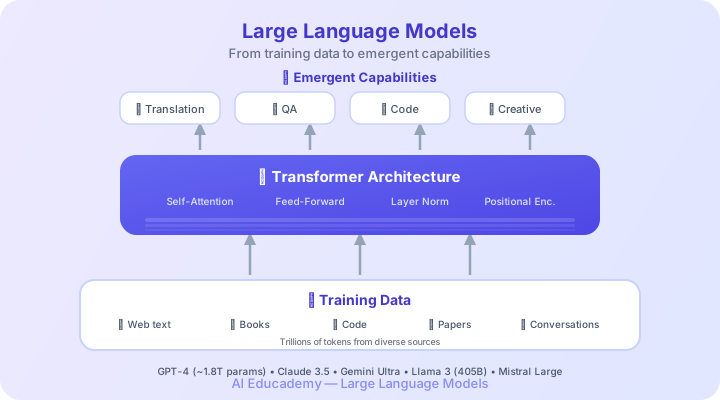
Les grands modèles de langage ont profondément changé ce que les machines peuvent faire avec le texte, le code et le raisonnement. Dans cette leçon, nous allons lever le voile sur leur fonctionnement, les raisons de leur puissance et les domaines où ils restent limités.
Un grand modèle de langage est un réseau de neurones entraîné sur d'énormes quantités de texte pour prédire le prochain token dans une séquence. Le mot « grand » renvoie au nombre de paramètres, c'est-à-dire les poids apprenables qui encodent les motifs issus des données d'entraînement.
Ces modèles sont entraînés sur des centaines de milliards de mots issus de livres, de sites web, de dépôts de code et d'articles universitaires. C'est l'ampleur des données et des paramètres qui donne aux LLM leur polyvalence remarquable.
Des tokens, pas des mots : les LLM ne traitent pas des mots entiers. Ils travaillent avec des tokens, c'est-à-dire des unités plus petites que les mots. Le mot « understanding » peut être découpé en « under » + « stand » + « ing ». Un mot anglais typique représente en moyenne environ 1,3 token. Ce système de tokenisation permet aux modèles de gérer les mots rares, le jargon technique et même plusieurs langues sans vocabulaire démesuré.
L'entraînement d'un modèle de langage de pointe peut coûter des centaines de millions en calcul, données, énergie et ingénierie. C'est à peu près le budget d'un grand film, sauf que « l'acteur » peut parler tous les langages de programmation.
Chaque LLM moderne repose sur le Transformer, introduit dans l'article de 2017 Attention Is All You Need. L'innovation clé est l'auto-attention, un mécanisme qui permet au modèle de pondérer l'importance de chaque mot par rapport à tous les autres mots de l'entrée.
Fonctionnement simplifié de l'auto-attention :
Connectez-vous pour rejoindre la discussion
La formule mathématique au coeur de l'attention est :
Attention(Q, K, V) = softmax(QK^T / √d) × V
La division par √d (la racine carrée de la dimension des clés) empêche les produits scalaires de devenir trop grands, ce qui pousserait la fonction softmax dans des zones aux gradients extrêmement faibles. Cette simple mise à l'échelle a été l'une des idées clés qui ont stabilisé l'entraînement de Transformers profonds.
Ce processus est répété en parallèle sur plusieurs têtes d'attention, ce qui permet au modèle de capturer simultanément différents types de relations, par exemple la syntaxe dans une tête et la sémantique dans une autre.
Si une phrase contient 500 tokens, l'auto-attention compare chaque token à tous les autres, soit 250 000 comparaisons par couche. Quel effet ce coût quadratique peut-il avoir sur ce que les LLM peuvent traiter ?
| Modèle | Créateur | Fonctionnalité notable | |-------|---------|-----------------| | GPT-6 Astra | OpenAI | Raisonnement de pointe, code, recherche et entrée multimodale | | Claude Opus 5.5 | Anthropic | Codage agentique de longue durée et travail de connaissance | | Gemini 3.1 Pro | Google DeepMind | Raisonnement avancé, code et multimodalité | | Llama 4 | Meta | Poids ouverts, multimodalité native, long contexte | | Mistral Large | Mistral AI | Alternative européenne efficace |
Le domaine évolue à une vitesse extraordinaire. Au moment où vous lirez ceci, des modèles plus récents existeront peut-être déjà.
Une distinction cruciale dans ce paysage oppose les modèles fermés (GPT, Claude, Gemini), pour lesquels seule l'API est disponible, aux modèles à poids ouverts (Llama, Mistral), dont les poids sont publiquement diffusés. Les modèles à poids ouverts permettent aux organisations d'exécuter l'inférence sur leur propre infrastructure, de les ajuster pour des domaines précis et d'inspecter leur comportement, des avantages très importants dans les secteurs sensibles à la confidentialité.
Tous les modèles dits « ouverts » ne sont pas réellement open source. Certains publient les poids, mais limitent l'usage commercial ou ne partagent pas les données et le code d'entraînement. Vérifiez toujours la licence avant de déployer un modèle à poids ouverts en production.
Les LLM sont construits en plusieurs étapes :
Pré-entraînement - Le modèle lit d'immenses volumes de texte et apprend à prédire le prochain token. Cette étape est extrêmement coûteuse et produit un modèle de base capable de compléter du texte, mais pas particulièrement utile.
Ajustement fin supervisé (SFT) - Des exemples de réponses idéales écrits par des humains apprennent au modèle à suivre les instructions et à répondre correctement aux questions.
RLHF (Reinforcement Learning from Human Feedback) - Des évaluateurs humains classent les sorties du modèle de la meilleure à la pire. Un modèle de récompense apprend ces préférences, puis le LLM est entraîné à maximiser la récompense. C'est ce qui rend les modèles utiles, inoffensifs et honnêtes.
Quel est l'objectif principal du RLHF dans l'entraînement des LLM ?
Quand les modèles changent d'échelle, ils développent des capacités qui n'ont pas été explicitement entraînées :
Ces propriétés émergentes sont l'un des aspects les plus fascinants du passage à l'échelle : des capacités qui semblent apparaître presque « gratuitement » une fois qu'un modèle franchit certains seuils de taille.
Les premiers modèles de pointe montraient clairement ce schéma : ils pouvaient réussir des examens professionnels difficiles tout en trébuchant encore sur de simples tâches d'arithmétique ou de comptage lorsque le prompt exposait leurs faiblesses.
Les LLM sont puissants, mais loin d'être parfaits :
Vérifiez toujours les faits critiques issus des sorties de LLM auprès de sources faisant autorité. Traitez les LLM comme un assistant de recherche brillant, mais peu fiable : extrêmement utile, mais jamais le dernier mot sur les questions factuelles.
Pourquoi les LLM produisent-ils parfois des hallucinations ?
Pendant des années, l'idée dominante était que plus grand, c'est toujours mieux : plus de paramètres, plus de données et plus de calcul amélioreraient régulièrement les performances. Cette « loi d'échelle » s'est remarquablement bien vérifiée jusqu'à la génération GPT-2, GPT-3, GPT-4 et les systèmes de pointe ultérieurs.
Cependant, des recherches récentes suggèrent que nous approchons peut-être de rendements décroissants avec l'échelle brute seule. L'attention se déplace vers :
Les grands modèles de langage représentent un véritable changement de paradigme en informatique. Comprendre leur architecture, leur pipeline d'entraînement et leurs limites n'est pas facultatif pour quiconque travaille sérieusement avec l'IA. C'est une base qui vous servira à mesure que le domaine continue d'évoluer.
Quelle étape de l'entraînement des LLM est la plus coûteuse en calcul ?
Si un LLM peut réussir l'examen du barreau, mais ne peut pas compter de manière fiable le nombre de lettres dans un mot, qu'est-ce que cela nous apprend sur la différence entre l'intelligence humaine et les capacités des modèles de langage ?