المصفوفات وخرائط التجزئة - كيف يقوم الذكاء الاصطناعي بتخزين البيانات واسترجاعها
تُرجِمت هذه الدروس تلقائيًا إلى العربية ولم تخضع بعد لمراجعة بشرية. إذا بدت أي صياغة غريبة، فالنسخة الإنجليزية هي المرجع.
ما أهمية تخزين البيانات في الذكاء الاصطناعي
يحتاج كل نظام ذكاء اصطناعي إلى تخزين البيانات واسترجاعها بسرعة. سواء أكان ذلك قائمة بقيم البكسل في صورة ما، أو مفردات مكونة من 50000 كلمة، أو ملايين من تفضيلات المستخدم، فإن اختيار بنية البيانات يحدد مدى سرعة تفكير الذكاء الاصطناعي لديك.
يهيمن هيكلان: المصفوفات وخرائط التجزئة. أتقن هذه الأمور، وستحصل على الأساس لكل مسارات الذكاء الاصطناعي تقريبًا.
المصفوفات - قوائم مرتبة مع إمكانية الوصول الفوري
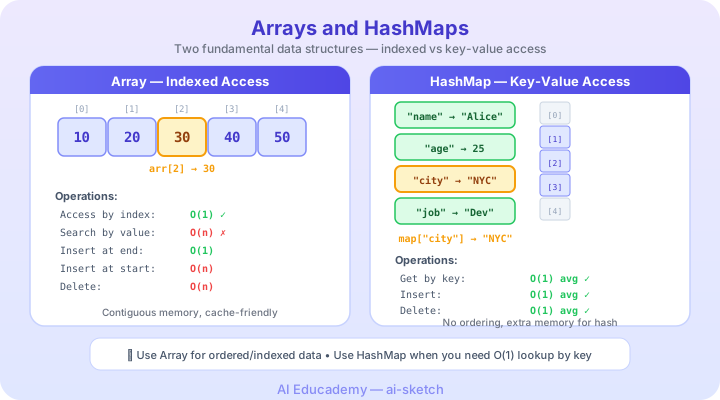
المصفوفة هي ببساطة قائمة مرقمة من العناصر المخزنة جنبًا إلى جنب في الذاكرة. يحتوي كل عنصر على فهرس - موضعه في القائمة، بدءًا من الصفر.
index:   0       1       2       3       4
value: ["cat", "dog", "bird", "fish", "frog"]
نظرًا لوجود العناصر بجوار بعضها البعض، يمكنك القفز مباشرة إلى أي موضع. تريد البند 3؟ تم - لا حاجة للبحث. هذا هو الوصول O(1)، مما يعني أن الأمر يستغرق نفس الوقت سواء كانت المصفوفة تحتوي على 10 عناصر أو 10 ملايين.
عندما تتألق المصفوفات
- متجهات الميزات: قد يتم تمثيل الصورة كمصفوفة مكونة من 784 رقمًا (28 × 28 بكسل)، يحمل كل منها قيمة سطوع.
- التضمينات: تخزن نماذج اللغة معاني الكلمات كمصفوفات من مئات أرقام الفاصلة العائمة.
- معالجة الدفعات: يتم تحميل بيانات التدريب في صفائف حتى تتمكن وحدة معالجة الرسومات من معالجة آلاف الأمثلة في وقت واحد.
الصيد
يعد إدخال أو إزالة العناصر في المنتصف أمرًا مكلفًا. يجب أن يتم خلط كل عنصر بعد التغيير. هذا O(n) - كلما زاد عدد العناصر، كلما استغرق الأمر وقتًا أطول.
إذا كانت لديك قائمة تشغيل تضم 10000 أغنية وأردت إدراج مسار جديد في الموضع 5، فستحتاج كل أغنية من الموضع 5 فصاعدًا إلى النقل. كيف يمكن لخدمة البث التعامل مع هذا دون تباطؤ؟
خرائط التجزئة - عمليات بحث فورية بالاسم
تقوم خريطة التجزئة (وتسمى أيضًا القاموس أو جدول التجزئة) بتخزين البيانات على هيئة أزواج قيمة المفتاح. بدلاً من الوصول إلى العناصر عن طريق رقم الفهرس، يمكنك الوصول إليها عن طريق مفتاح ذي معنى.
word_counts = {
  "hello": 42,
  "world": 37,
  "AI": 156
}
النقاش
سجّل الدخول للانضمام إلى النقاش