رؤية الكمبيوتر - كيف يتعلم الذكاء الاصطناعي رؤية العالم
تُرجِمت هذه الدروس تلقائيًا إلى العربية ولم تخضع بعد لمراجعة بشرية. إذا بدت أي صياغة غريبة، فالنسخة الإنجليزية هي المرجع.
رؤية الكمبيوتر - كيف يتعلم الذكاء الاصطناعي رؤية العالم
يمكنك إلقاء نظرة على الصورة وتعرف على الفور أنها تظهر كلبًا على الشاطئ. بالنسبة للكمبيوتر، تلك الصورة نفسها ليست أكثر من شبكة عملاقة من الأرقام. الرؤية الحاسوبية هي أحد فروع الذكاء الاصطناعي الذي يعلّم الآلات كيفية استخلاص المعنى من تلك الأرقام، وهي تعمل بالفعل على إعادة تشكيل الصناعات من حولك.
كيف "ترى" أجهزة الكمبيوتر
عندما تنظر إلى صورة فوتوغرافية، يتعرف عقلك على الفور على الأشكال والألوان والعمق. جهاز كمبيوتر ليس لديه أي من هذا الحدس. بدلا من ذلك، فإنه يعمل مع الأرقام الأولية.
الصورة الرقمية عبارة عن شبكة من وحدات البكسل. يقوم كل بكسل بتخزين قيم الألوان - عادةً ثلاثة القنوات: الأحمر والأخضر والأزرق (RGB). تحتوي الصورة بدقة 1920 × 1080 عالية الدقة على أكثر من مليوني بكسل، لكل منها ثلاث قيم تتراوح من 0 إلى 255. اضربها معًا حتى تتمكن من الحصول على إطار واحد يحتوي على ملايين الأرقام.
الدقة تحدد مقدار التفاصيل التي تلتقطها الشبكة. الدقة الأعلى تعني المزيد من البكسلات وتفاصيل أكثر ثراءً - ولكن أيضًا المزيد من البيانات التي يمكن للذكاء الاصطناعي معالجتها. تحتوي الصورة بدقة 4K على أربعة أضعاف بكسل HD، وهو ما يعني أربعة أضعاف التكلفة الحسابية.
تحتوي الصور ذات التدرج الرمادي على قناة واحدة فقط (السطوع)، في حين أن بعض التنسيقات المتخصصة - مثل صور الأقمار الصناعية أو الفحوصات الطبية - قد تحتوي على عشرات القنوات التي تلتقط أطوال موجية غير مرئية إلى العين البشرية.
يمكن للعين البشرية تمييز ما يقرب من 10 ملايين لون. يمكن لصورة RGB القياسية 8 بت أن تمثل أكثر من 16.7 مليون مجموعة ألوان فريدة - أكثر مما يمكننا إدراكه بالفعل!
الشبكات العصبية التلافيفية (CNNs)
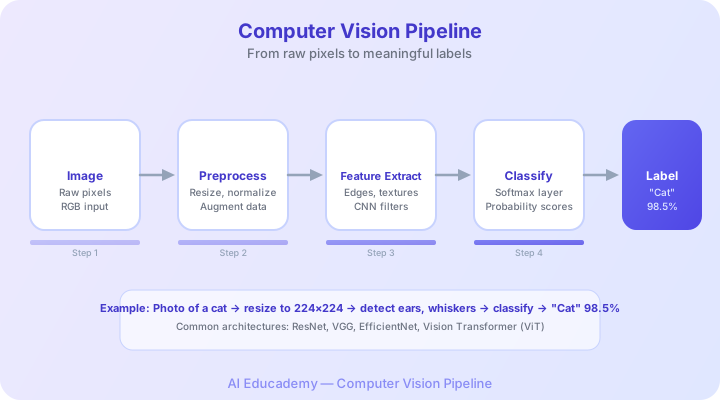
اعتمدت المحاولات المبكرة للرؤية الحاسوبية على قواعد مصنوعة يدويًا - "ابحث عن الحواف هنا، وطابق هذا القالب هناك." لقد فشلت هذه الأساليب الهشة كلما تغير المشهد. استخدام الأنظمة الحديثة الشبكات العصبية التلافيفية (CNNs)، التي تتعلم قواعدها الخاصة من آلاف الشبكات المُصنَّفة أمثلة.
فكر في CNN كخط تجميع لكاشفات الأنماط، كل طبقة مبنية على الطبقة التي قبلها:
- الطبقات التلافيفية مرر المرشحات الصغيرة عبر الصورة، واكتشف الأنماط البسيطة مثل الحواف والزوايا والقوام.
- طبقات التجميع تعمل على تقليص البيانات، مع الاحتفاظ فقط بالإشارات الأكثر أهمية والتخلص منها تفاصيل زائدة عن الحاجة.
- طبقات تلافيفية أعمق تجمع هذه الأنماط البسيطة في ميزات أكثر تعقيدًا - العيون، العجلات والحروف.
- تجمع كل الميزات معًا لاتخاذ القرار النهائي - "هذا قطة" أو "هذا ورم".
النقاش
سجّل الدخول للانضمام إلى النقاش