计算机视觉 - 人工智能如何学会看世界
本课程由机器自动翻译成中文,尚未经过人工校对。如果读起来有些奇怪,请以英文原文为准。
计算机视觉 - 人工智能如何学会看世界
你看一眼照片,立刻就知道照片上有一只狗在海滩上。对于计算机来说,同一张图像只不过是一个巨大的数字网格。 计算机视觉是人工智能的一个分支,它教会机器从这些数字中提取含义 - 它已经在重塑您周围的行业。
计算机如何“看”
当你看照片时,你的大脑会立即识别形状、颜色和深度。一台电脑 没有那种直觉。相反,它使用原始数字。
数字图像是像素的网格。每个像素存储颜色值 - 通常为三个 通道:红、绿、蓝 (RGB)。 1920×1080高清图像包含超过200万像素, 每个都有 0 到 255 之间的三个值。将它们相乘,甚至是一个帧 包含数百万个数字。
分辨率决定网格捕获多少细节。更高的分辨率意味着更多的像素 以及更丰富的细节 - 而且还有更多的数据可供人工智能处理。 4K 图像的四倍 高清像素,这意味着四倍的计算成本。
灰度图像只有一个通道(亮度),而一些特殊格式 - 例如 卫星图像或医学扫描 - 可能有数十个通道捕获不可见的波长 对人眼来说。
人眼可以辨别大约 1000 万种颜色。标准 8 位 RGB 图像可以代表超过 1670 万种独特的颜色组合 - 比我们实际感知的还要多!
卷积神经网络 (CNN)
计算机视觉的早期尝试依赖于手工制定的规则 - “在这里寻找边缘,匹配这个 那里有模板。”当场景发生变化时,这些脆弱的方法就会失败。现代系统使用 卷积神经网络 (CNN),它从数千个标记中学习自己的规则 例子。
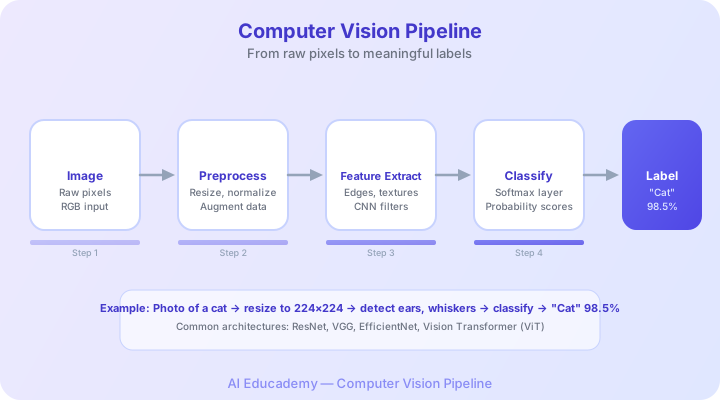
将 CNN 视为模式检测器的装配线,每一层都建立在前一层之上:
- 卷积层 在图像上滑动小过滤器,检测简单的模式,例如 边缘、角落和纹理。
- 池化层缩小数据,仅保留最重要的信号并丢弃 多余的细节。
- 更深的卷积层将这些简单的模式组合成更复杂的特征 - 眼睛, 轮子,字母。
- 完全连接的层将所有特征放在一起做出最终决定 - “这是一个 猫”或“这是肿瘤。”
美妙之处在于没有人手动编程这些过滤器。网络在训练过程中学习它们,从随机噪声开始,逐渐锐化为有用的检测器。
当你学习识别朋友的面孔时,你不会记住每个像素 - 你会记住眼睛形状、发型和表情等关键特征。 CNN 做的事情非常相似。您认为 CNN 会首先学习哪些特征?
分类、检测和分割
计算机视觉解决三个逐渐困难的任务:
|任务|提问即回答 |示例| |------|--------------------|---------| | 图像分类 |这张图片里有什么? | “这张X光片显示肺炎。” | | 物体检测 |这张图片中有什么以及在哪里? |在街景中的每个行人周围画出方框。 | | 语义分割 |哪些像素属于哪个对象? |对道路、人行道、汽车和天空的每个像素进行不同的着色。 |
自动驾驶汽车同时需要这三者 - 对物体进行分类、精确定位,以及 逐个像素地了解整个场景。
每项任务都需要逐渐增加的计算能力和训练数据。分类为 到2015年基本解决;视频实时分割仍然是当今的一个活跃的研究领域。
哪个计算机视觉任务为图像中的每个像素分配标签?
实际应用
计算机视觉已经嵌入到您可能意想不到的行业中:
- 特斯拉自动驾驶仪使用八个摄像头和基于视觉的人工智能来检测车道、交通灯和 实时障碍物 - 每次旅程处理数百万帧。
- 医学成像 - 在发现早期乳房方面,人工智能模型现在可以与放射科医生相媲美或超过放射科医生 乳房X光检查中的癌症有时可以发现六位人类专家错过的情况。
- - 工厂使用视觉系统每分钟检查数千种产品, 对于人类检查员来说,发现缺陷太微妙或太快。
讨论
登录 后参与讨论