AI EducademyAIEducademy
🌳

AI పునాదులు

🌱
AI Seeds

వాస్తవ ప్రపంచానికి AI అక్షరాస్యత

🌿
AI Sprouts

మేధో వ్యవస్థల వెనుక పునాదులు

🌳
AI Branches

నేటి AI సామర్థ్యాలతో రూపొందించండి

🏕️
AI Canopy

ఇంజనీర్ నమ్మదగిన GenAI వ్యవస్థలు

🌲
AI Forest

AI ఉత్పత్తులను బాధ్యతాయుతంగా రవాణా చేయండి

🔨

AI నైపుణ్యం

✏️
AI Sketch

AI బిల్డర్ల కోసం ఇంజనీరింగ్ పునాదులు

🪨
AI Chisel

క్లిష్టమైన సమస్యలను పరిష్కరించడానికి నమూనాలు

⚒️
AI Craft

AIని స్కేల్ చేసే డిజైన్ సిస్టమ్‌లు

💎
AI Polish

AI యుగంలో కమ్యూనికేట్ చేయండి మరియు నాయకత్వం వహించండి

🏆
AI Masterpiece

మీ ఉత్పత్తి AI క్యాప్‌స్టోన్

🚀

కెరీర్ రెడీ

🚀
ఇంటర్వ్యూ లాంచ్‌ప్యాడ్

AI ఇంజనీరింగ్ జాబ్ మార్కెట్‌ను నావిగేట్ చేయండి

🌟
ప్రవర్తనా ఇంటర్వ్యూ నైపుణ్యం

మీరు ప్రభావాన్ని ఎలా సృష్టిస్తారో కథ చెప్పండి

💻
సాంకేతిక ఇంటర్వ్యూలు

ఒత్తిడిలో పరిష్కరించండి, రూపకల్పన చేయండి మరియు కమ్యూనికేట్ చేయండి

🤖
AI & ML ఇంటర్వ్యూలు

ఆధునిక ML మరియు GenAI ఇంటర్వ్యూల కోసం సిద్ధం చేయండి

🏆
ఆఫర్ & అంతకు మించి

నమ్మకంగా, సమాచారంతో తదుపరి కదలికను చేయండి

అన్ని ప్రోగ్రామ్‌లు చూడండి→

ల్యాబ్

7 ప్రయోగాలు లోడ్ అయ్యాయి
🧠న్యూరల్ నెట్‌వర్క్ ప్లేగ్రౌండ్🤖AI లేదా మనిషి?💬ప్రాంప్ట్ ల్యాబ్🎨ఇమేజ్ జనరేటర్😊సెంటిమెంట్ ఎనలైజర్💡చాట్‌బాట్ బిల్డర్⚖️ఎథిక్స్ సిమ్యులేటర్
🎯మాక్ ఇంటర్వ్యూల్యాబ్‌లోకి వెళ్ళండి→
ప్రయాణంబ్లాగ్
🎯
మా గురించి

ప్రతి చోటా, ప్రతి ఒక్కరికీ AI విద్యను అందుబాటులోకి తీసుకురావడం

❓
తరచుగా అడిగే ప్రశ్నలు

సాధారణ ప్రశ్నలకు సమాధానాలు

🧰
AI టూల్స్

మేము వాడే, సిఫార్సు చేసే ఎంపిక చేసిన టూల్స్

✉️
సంప్రదించండి

మమ్మల్ని సంప్రదించండి

⭐
ఓపెన్ సోర్స్

GitHub లో బహిరంగంగా నిర్మించబడింది

ధరలు
నేర్చుకోవడం ప్రారంభించండి
AI EducademyAIEducademy

© 2026 AI Educademy. సర్వ హక్కులు ప్రత్యేకించబడ్డాయి.

నేర్చుకోండి

  • ప్రోగ్రాములు
  • పాఠాలు
  • ల్యాబ్
  • ఏఐ స్టార్టర్ కిట్
  • ధరలు

సంఘం

  • GitHub
  • సహకరించండి
  • ప్రవర్తనా నియమావళి
  • మా గురించి
  • తరచుగా అడిగే ప్రశ్నలు

మద్దతు

  • కాఫీ కొనండి ☕
  • సేవా నిబంధనలు
  • గోప్యతా విధానం
  • సంప్రదించండి
  • Sitemap
AI & ఇంజనీరింగ్ ప్రోగ్రామ్‌లు›🌿 AI Sprouts›పాఠాలు›డేటాసెట్లు మరియు డేటా - AI యొక్క ఇంధనం
📊
AI Sprouts • ప్రారంభకుడు⏱️ 12 నిమిషాల పఠన సమయం

డేటాసెట్లు మరియు డేటా - AI యొక్క ఇంధనం

లెవల్ 2కి స్వాగతం! 👋

AI Seeds లో మీరు నేర్చుకున్నారు AI ఉదాహరణల నుండి నేర్చుకుంటుందని - పిల్లలు బొమ్మల పుస్తకాల నుండి జంతువులను గుర్తించడం నేర్చుకున్నట్లే. కానీ ఆ ఉదాహరణలు ఎక్కడ నుండి వస్తాయి?

సమాధానం డేటా - మరియు ఇది AI లో అత్యంత ముఖ్యమైన అంశం. చెడ్డ డేటా = చెడ్డ AI. మంచి డేటా = మంచి AI.
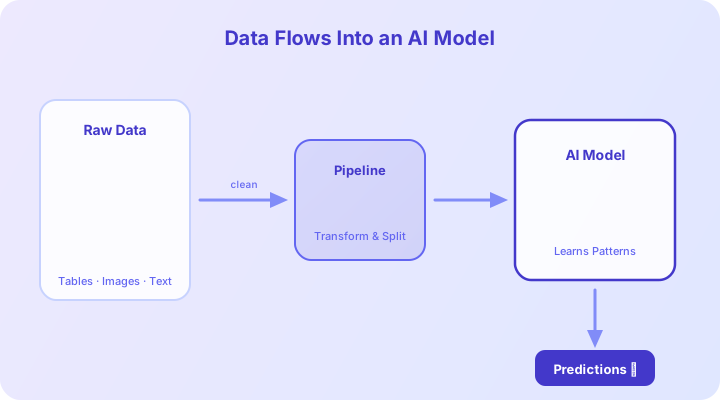
డేటా AI మోడల్‌లోకి ఇంధనంలా ప్రవహిస్తుంది
డేటా ప్రతి AI సిస్టమ్‌కు ఇంధనం

డేటా అంటే ఏమిటి? 🤔

డేటా అంటే నమోదు చేయబడిన సమాచారం. ప్రతి డిజిటల్ చర్య డేటా సృష్టిస్తుంది:

  • 📸 ఫోటో తీయడం → ఇమేజ్ డేటా
  • 💬 మెసేజ్ పంపడం → పాఠ్యం డేటా
  • 🎵 పాట వినడం → వినే చరిత్ర
  • 🛒 ఆన్‌లైన్‌లో కొనడం → లావాదేవీ డేటా
  • 📍 Google మ్యాప్‌లు తెరవడం → లొకేషన్ డేటా

AI లో మనం ఈ సమాచారాన్ని సేకరించి, క్రమబద్ధం చేసి, మెషీన్లకు నేర్పించడానికి ఉపయోగిస్తాం.


స్ట్రక్చర్డ్ vs అన్‌స్ట్రక్చర్డ్ డేటా

📋 స్ట్రక్చర్డ్ డేటా

వరుసలు మరియు నిలువు వరుసలలో సరిపోయే డేటా - స్ప్రెడ్‌షీట్ లాగా.

| పేరు | వయస్సు | నగరం | ఇష్టమైన రంగు | |------|--------|------|-------------| | ఆయిషా | 14 | లండన్ | నీలం | | రవి | 16 | హైదరాబాద్ | ఆకుపచ్చ | | ఎమ్మా | 15 | ఆమ్‌స్టర్‌డామ్ | ఎరుపు |

🖼️ అన్‌స్ట్రక్చర్డ్ డేటా

టేబుల్‌లో సరిపోని డేటా - ఇమేజ్‌లు, వీడియోలు, ఆడియో, ఇ-మెయిల్‌లు, సోషల్ మీడియా పోస్ట్‌లు.

🤯

ప్రపంచ డేటాలో 80% కంటే ఎక్కువ అన్‌స్ట్రక్చర్డ్! ఫోటోలు, వీడియోలు మరియు మెసేజ్‌లు స్ప్రెడ్‌షీట్‌ల కంటే చాలా ఎక్కువ. ఆధునిక డీప్ లెర్నింగ్ ఈ అస్తవ్యస్తమైన డేటాను నిర్వహించడానికే రూపొందించబడింది.


ట్రైనింగ్, వాలిడేషన్ మరియు టెస్ట్ డేటా

పరీక్షకు చదివేటప్పుడు, మీరు పుస్తకం మాత్రమే చదవరు - ప్రాక్టీస్ ప్రశ్నలు చేస్తారు, తర్వాత నిజమైన పరీక్ష రాస్తారు. AI కూడా అలాగే చేస్తుంది:

📚 ట్రైనింగ్ డేటా (పాఠ్యపుస్తకం)

అతిపెద్ద భాగం - మొత్తం డేటాలో 70-80%. AI మోడల్ ఇది అధ్యయనం చేసి నమూనాలు నేర్చుకుంటుంది.

📝 వాలిడేషన్ డేటా (ప్రాక్టీస్ ప్రశ్నలు)

సుమారు 10-15%. ట్రైనింగ్ సమయంలో ప్రగతి తనిఖీ చేయడానికి.

🎓 టెస్ట్ డేటా (తుది పరీక్ష)

మిగిలిన 10-15%. ట్రైనింగ్ తర్వాత ఉపయోగించబడుతుంది. మోడల్ ఈ డేటాను ఎప్పుడూ చూడలేదు.

from sklearn.model_selection import train_test_split

# విభజన: 80% ట్రైనింగ్, 20% తాత్కాలిక
train_data, temp_data = train_test_split(all_data, test_size=0.2)

# తాత్కాలిక సెట్ విభజన: సగం వాలిడేషన్, సగం టెస్ట్
val_data, test_data = train_test_split(temp_data, test_size=0.5)

print(f"Training: {len(train_data)}")
print(f"సరైనదిation: {len(val_data)}")
print(f"Test: {len(test_data)}")
🤔
Think about it:

మోడల్‌ను అదే డేటాపై ఎందుకు టెస్ట్ చేయలేము? ఎందుకంటే విద్యార్థికి ముందుగానే పరీక్ష ప్రశ్నలు ఇవ్వడం లాంటిది - పూర్తి మార్కులు వస్తాయి కానీ నిజమైన అవగాహన ఉండదు.

16 యొక్క పాఠం 10% పూర్తి
←ప్రోగ్రామ్‌కు తిరిగి
కొనసాగించండి: అల్గారిథమ్‌లు వివరించబడ్డాయి - AI యొక్క రెసిపీలు→

చర్చ

సైన్ ఇన్ చేయండి చర్చలో పాల్గొనడానికి

ఈ పాఠానికి మార్పు సూచించండి

డేటా బయాస్ - ఎందుకు ముఖ్యం ⚖️

AI అది నేర్చుకునే డేటా అంత న్యాయమైనది మాత్రమే.

మీరు ఫేస్ రికగ్నిషన్ సిస్టమ్‌ను ఎక్కువగా తెల్లటి చర్మం ఉన్న వ్యక్తుల ఫోటోలతో ట్రైన్ చేస్తే, ముదురు చర్మం ఉన్న ముఖాలపై బాగా పనిచేయదు.

బయాస్ ఉదాహరణలు:

  • 🏥 హెల్త్‌కేర్ AI ఎక్కువగా పురుషుల డేటాపై ట్రైన్ - మహిళల్లో తప్పుడు రోగనిర్ధారణ
  • 💼 హైరింగ్ AI చారిత్రక రెజ్యూమ్‌లపై ట్రైన్ - మహిళా అభ్యర్థులకు నష్టం
  • 🚗 స్వయంచాలక డ్రైవింగ్ కారులు ఎండ కాలిఫోర్నియాలో ట్రైన్ - వర్షం మరియు మంచులో ఇబ్బంది
💡

బయాస్ ఎల్లప్పుడూ స్పష్టంగా కనిపించదు. మీ డేటాసెట్‌లో 90% ఆంగ్ల పాఠ్యం ఉంటే, మీ AI ఆంగ్లంలో అద్భుతంగా కానీ హిందీ, తెలుగు లేదా డచ్‌లో బలహీనంగా ఉంటుంది. ఎల్లప్పుడూ అడగండి: "ఈ డేటాలో ఎవరు లేరు?"


ప్రసిద్ధ డేటాసెట్లు 🌍

✍️ MNIST

  • ఏమిటి: చేతిరాత అంకెల (0-9) 70,000 ఇమేజ్‌లు
  • ప్రాముఖ్యత: మెషిన్ లెర్నింగ్ యొక్క "హలో ప్రపంచం"

🖼️ ImageNet

  • ఏమిటి: 20,000+ వర్గాలలో 14 మిలియన్ కంటే ఎక్కువ లేబుల్ చేసిన ఇమేజ్‌లు
  • ప్రాముఖ్యత: ImageNet పోటీ (2010-2017) ఇమేజ్ రికగ్నిషన్‌లో భారీ మెరుగుదలలు తెచ్చింది

🌐 సాధారణ క్రాల్

  • ఏమిటి: 2008 నుండి సేకరించిన పెటాబైట్ల వెబ్ డేటా
  • ప్రాముఖ్యత: GPT వంటి పెద్ద భాషా మోడల్‌లను ఇది నడుపుతుంది

🗣️ LibriSpeech

  • ఏమిటి: 1,000 గంటల చదివిన ఆంగ్ల స్పీచ్
  • ప్రాముఖ్యత: వాయిస్ అసిస్టెంట్ వంటి స్పీచ్ రికగ్నిషన్ సిస్టమ్‌లను ట్రైన్ చేయడానికి
🤯

మొత్తం MNIST డేటాసెట్ 15 MB కంటే తక్కువ - ఒక స్మార్ట్‌ఫోన్ ఫోటో కంటే చిన్నది! అయినా ఇది వేలాది AI కెరీర్‌లను ప్రారంభించింది.


ప్రాక్టీస్: డేటాసెట్ అన్వేషించడం 🔬

ప్రసిద్ధ Iris డేటాసెట్ అన్వేషించండి - 4 లక్షణాలతో 150 పూల కొలతలు.

import pandas as pd
from sklearn.datasets import load_iris

# డేటాసెట్ లోడ్ చేయండి
iris = load_iris()
df = pd.DataFrame(iris.data, columns=iris.feature_names)
df['species'] = [iris.target_names[t] for t in iris.target]

# ప్రాథమిక అన్వేషణ
print("Shape:", df.shape)
print("\nమొదటి 5 వరుసలు:")
print(df.head())

print("\nజాతుల గణన:")
print(df['species'].value_counts())

print("\nప్రాథమిక గణాంకాలు:")
print(df.describe())

డేటాసెట్ అన్వేషించేటప్పుడు ఎల్లప్పుడూ అడగండి:

  1. ఎన్ని శాంపిల్స్? (వరుసలు)
  2. ఎన్ని లక్షణాలు? (నిలువు వరుసలు)
  3. క్లాసులు సమతుల్యంగా ఉన్నాయా?
  4. ఏదైనా విలువలు లేవా?
  5. సంఖ్యలు ఎలా కనిపిస్తున్నాయి? (పరిధి, సగటు, వ్యాప్తి)

సారాంశం 🎯

  1. డేటా నమోదు చేయబడిన సమాచారం - ఫోటోలు, మెసేజ్‌లు, క్లిక్‌లు
  2. స్ట్రక్చర్డ్ డేటా టేబుల్‌లో సరిపోతుంది; అన్‌స్ట్రక్చర్డ్ డేటా సరిపోదు
  3. డేటాను ట్రైనింగ్, వాలిడేషన్ మరియు టెస్ట్ సెట్‌లుగా విభజిస్తారు
  4. డేటా బయాస్ అన్యాయమైన AI కి దారితీస్తుంది - ఎవరు లేరో అడగండి
  5. MNIST, ImageNet మరియు సాధారణ క్రాల్ వంటి డేటాసెట్లు నేటి AI కి శక్తినిస్తాయి
  6. మోడల్ నిర్మించే ముందు ఎల్లప్పుడూ డేటా అన్వేషించండి

తదుపరి ఏమిటి? 🚀

ఇప్పుడు మీకు AI ని ఏది శక్తివంతం చేస్తుందో తెలుసు. తదుపరి పాఠంలో మనం అల్గారిథమ్‌లు తెలుసుకుందాం - డేటాను తెలివైన నిర్ణయాలుగా మార్చే స్టెప్-బై-స్టెప్ రెసిపీలు!