అర్రేలు మరియు హాష్ మ్యాప్లు - AI డేటాను ఎలా నిల్వ చేసి తిరిగి పొందుతుంది
AI లో డేటా నిల్వ ఎందుకు ముఖ్యం
ప్రతి AI వ్యవస్థకు డేటాను వేగంగా నిల్వ చేయడం మరియు తిరిగి పొందడం అవసరం. అది ఒక చిత్రంలోని పిక్సెల్ విలువల జాబితా అయినా, 50,000 పదాల పదకోశం అయినా, లేదా లక్షలాది వినియోగదారుల అభిరుచులు అయినా - డేటా నిర్మాణం ఎంపిక మీ AI ఎంత వేగంగా ఆలోచించగలదో నిర్ణయిస్తుంది.
రెండు నిర్మాణాలు ప్రాధాన్యత వహిస్తాయి: అర్రేలు మరియు హాష్ మ్యాప్లు. వీటిని నేర్చుకుంటే, దాదాపు ప్రతి AI పైప్లైన్ కి పునాది ఏర్పడుతుంది.
అర్రేలు - తక్షణ ప్రాప్యతతో క్రమబద్ధమైన జాబితాలు
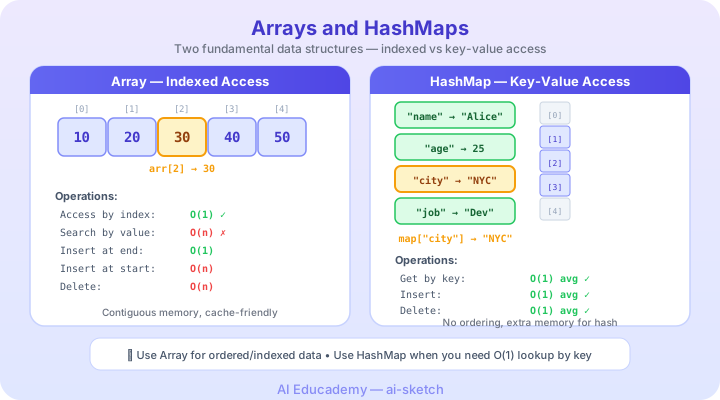
అర్రే అనేది మెమరీలో పక్కపక్కనే నిల్వ చేయబడిన అంశాల సంఖ్యాంక జాబితా. ప్రతి అంశానికి ఒక ఇండెక్స్ ఉంటుంది - జాబితాలో దాని స్థానం, సున్నా నుండి మొదలవుతుంది.
index:   0       1       2       3       4
value: ["cat", "dog", "bird", "fish", "frog"]
అంశాలు పక్కపక్కనే ఉన్నందున, మీరు ఏ స్థానానికైనా నేరుగా వెళ్ళవచ్చు. 3వ అంశం కావాలా? అయిపోయింది - వెతకడం అవసరం లేదు. ఇది O(1) ప్రాప్యత, అంటే అర్రే లో 10 లేదా 10 మిలియన్ అంశాలు ఉన్నా ఒకే సమయం పడుతుంది.
అర్రేలు ఎప్పుడు రాణిస్తాయి
- ఫీచర్ వెక్టర్లు: ఒక చిత్రాన్ని 784 సంఖ్యల అర్రే గా (28×28 పిక్సెల్లు) సూచించవచ్చు, ప్రతిదానిలో ప్రకాశ విలువ ఉంటుంది.
- ఎంబెడ్డింగ్లు: భాషా నమూనాలు పదాల అర్థాలను వందలాది ఫ్లోటింగ్-పాయింట్ సంఖ్యల అర్రేలు గా నిల్వ చేస్తాయి.
- Batch ప్రాసెసింగ్: GPU వేలాది ఉదాహరణలను ఏకకాలంలో ప్రాసెస్ చేయడానికి శిక్షణ డేటాను అర్రేలు లో లోడ్ చేస్తారు.
పరిమితి
మధ్యలో చేర్చడం లేదా తొలగించడం ఖరీదైనది. మార్పు తర్వాత ప్రతి అంశం జరగాలి. ఇది O(n) - ఎక్కువ అంశాలు ఉంటే, ఎక్కువ సమయం పడుతుంది.
మీ దగ్గర 10,000 పాటల ప్లేలిస్ట్ ఉంటే, 5వ స్థానంలో కొత్త పాట చేర్చాలనుకుంటే, 5వ స్థానం నుండి ప్రతి పాట జరగాలి. ఒక స్ట్రీమింగ్ సేవ నెమ్మదించకుండా దీన్ని ఎలా నిర్వహించవచ్చు?
హాష్ మ్యాప్లు - పేరు ద్వారా తక్షణ అన్వేషణ
హాష్ మ్యాప్ (నిఘంటువు లేదా హాష్ టేబుల్ అని కూడా పిలుస్తారు) డేటాను కీలక-విలువ జతలు గా నిల్వ చేస్తుంది. ఇండెక్స్ సంఖ్య ద్వారా కాకుండా, అర్థవంతమైన కీలక ద్వారా అంశాలను ప్రాప్తి చేస్తారు.
word_counts = {
  "hello": 42,
  "world": 37,
  "AI": 156
}
చర్చ
సైన్ ఇన్ చేయండి చర్చలో పాల్గొనడానికి