AI ఉత్పత్తులు నిర్మించడం - ప్రోటోటైప్ నుండి ప్రొడక్షన్ వరకు
AI ఉత్పత్తి జీవితచక్రం 🏭
AI ఎలా పని చేస్తుందో మీరు నేర్చుకున్నారు - డేటా, అల్గారిథమ్లు, న్యూరల్ నెట్వర్క్లు, ట్రాన్స్ఫార్మర్లు మరియు టూల్స్. ఇప్పుడు అన్నింటినీ కలిపి నిజమైనది నిర్మించే సమయం వచ్చింది.
AI ఉత్పత్తి నిర్మించడం సాంప్రదాయ సాఫ్ట్వేర్ నిర్మించడం కంటే ప్రాథమికంగా భిన్నంగా ఉంటుంది. మోడల్లు క్షీణిస్తాయి, డేటా మారుతుంది, నోట్బుక్లో పనిచేసేది ప్రొడక్షన్లో తరచుగా విఫలమవుతుంది.
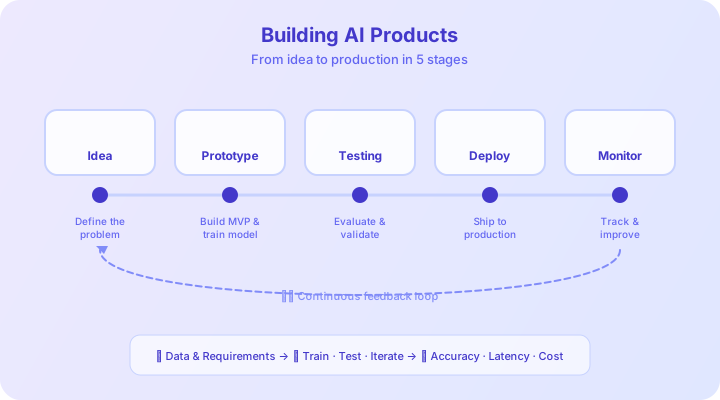
దశ 1: సమస్యనుర్వచనం మరియు సాధ్యత 🎯
- AI నిజంగా అవసరమా? చాలా సమస్యలు నియమాలు లేదా సరళ గణాంకాలతో బాగా పరిష్కరించబడతాయి
- మీ దగ్గర డేటా ఉందా? AI దాని నుండి నేర్చుకునే డేటా అంత మంచిగానే ఉంటుంది
- విజయం ఎలా కనిపిస్తుంది? ముందుగానే కొలవగల మెట్రిక్లను నిర్వచించండి
- రిస్క్లు ఏమిటి? ఫాల్స్ పాజిటివ్లు వర్సెస్ ఫాల్స్ నెగటివ్లు - ఏది చెడ్డది?
నిర్ణయ ఫ్రేమ్వర్క్: మీరు AI ఉపయోగించాలా?
──────────────────────────────────────────────
✅ AI ఉపయోగించండి:
• నమూనా చేతితో వ్రాసిన నియమాలకు చాలా సంక్లిష్టంగా ఉన్నప్పుడు
• మీ దగ్గర తగినంత లేబుల్ చేసిన డేటా ఉన్నప్పుడు
• సమస్య కొంత లోపాన్ని సహిస్తున్నప్పుడు
❌ AI వదిలేయండి:
• సరళ నియమాలు సమస్యను పరిష్కరించినప్పుడు
• 100% ఖచ్చితత్వం అవసరమైనప్పుడు
• డేటా అరుదుగా ఉన్నప్పుడు
ఒక పెద్ద రిటైలర్ AI సిఫారసు ఇంజిన్ నిర్మించడంలో కోట్ల రూపాయలు ఖర్చు చేసి, సరళమైన "కస్టమర్లు కూడా కొన్నారు" లుక్అప్ టేబుల్ దాదాపు అంతే బాగా పని చేస్తుందని కనుగొన్నారు. ఎల్లప్పుడూ పని చేయగల అతి సరళమైన పరిష్కారంతో ప్రారంభించండి.
దశ 2: సరైన మోడల్ ఎంచుకోవడం 🧩
సాంప్రదాయ ML - టేబులర్ డేటా, వ్యాఖ్యానతత్వం, పరిమిత డేటా
డీప్ లర్నింగ్ - ఇమేజ్లు, ఆడియో, వీడియో, టెక్స్ట్, పెద్ద డేటాసెట్లు
పెద్ద భాష మోడల్లు - టెక్స్ట్ జనరేషన్, సారాంశం, Q&A, వేగవంతమైన ప్రోటోటైపింగ్
ముందుగా శిక్షణ పొందిన API లు - ప్రామాణిక పనులు, వేగవంతమైన ఏకీకరణ
def model_enchukoni(samasya):
    if samasya.data_rakam == "tabular":
        return "XGBoost leda Random Forest"
    if samasya.data_rakam in ["image", "audio", "video"]:
        return "Pre-trained model ni fine-tune cheyandi"
    if samasya.data_rakam == "text":
        if samasya.panulu == "generation":
            return "LLM (GPT, Claude, Llama)"
        return "Fine-tuned BERT leda Sentence Transformers"
    return "Saralanga prarambhinchandi, iterate cheyandi"
చర్చ
సైన్ ఇన్ చేయండి చర్చలో పాల్గొనడానికి