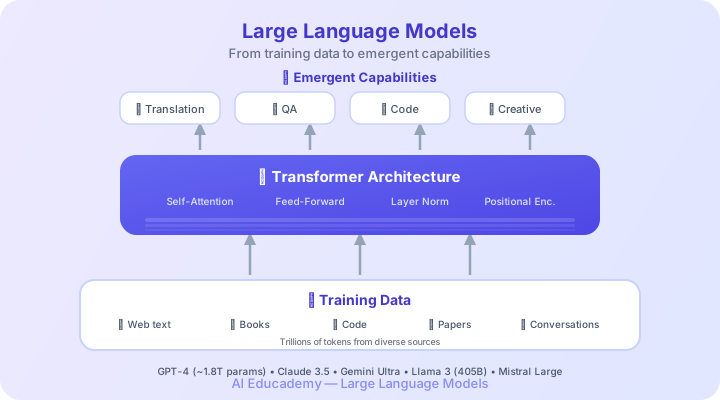
లార్జ్ లాంగ్వేజ్ మోడల్స్ టెక్స్ట్, కోడ్, తార్కిక ఆలోచనలతో యంత్రాలు చేయగల పనులను పూర్తిగా మార్చేశాయి. ఈ పాఠంలో అవి ఎలా పనిచేస్తాయి, ఎందుకు అంత శక్తివంతంగా ఉంటాయి, ఇంకా ఎక్కడ పరిమితులు ఉంటాయి అన్నది చూస్తాం.
లార్జ్ లాంగ్వేజ్ మోడల్ అనేది ఒక క్రమంలో తదుపరి టోకెన్ను అంచనా వేయడానికి అపారమైన టెక్స్ట్పై శిక్షణ పొందిన న్యూరల్ నెట్వర్క్. "లార్జ్" అనేది పారామీటర్ల సంఖ్యను సూచిస్తుంది. పారామీటర్లు అంటే శిక్షణ డేటాలోని నమూనాలను ఎన్కోడ్ చేసే, నేర్చుకోగల బరువులు.
ఈ మోడళ్లు పుస్తకాలు, వెబ్సైట్లు, కోడ్ రిపోజిటరీలు, విద్యా పత్రాల నుండి తీసుకున్న వందల బిలియన్ పదాలపై శిక్షణ పొందుతాయి. డేటా మరియు పారామీటర్ల ఈ విస్తారమైన పరిమాణమే LLMలకు అసాధారణమైన బహుముఖ సామర్థ్యాన్ని ఇస్తుంది.
పదాలు కాదు, టోకెన్లు: LLMలు పూర్తి పదాలను ప్రాసెస్ చేయవు. అవి పదాల కంటే చిన్న యూనిట్లైన టోకెన్లతో పనిచేస్తాయి. "understanding" అనే పదం "under" + "stand" + "ing"గా విడిపోవచ్చు. సాధారణ ఆంగ్ల పదం సగటున సుమారు 1.3 టోకెన్లు ఉంటుంది. ఈ టోకనీకరణ విధానం అరుదైన పదాలు, సాంకేతిక పరిభాష, అనేక భాషలను అసాధ్యంగా పెద్ద పదజాలం లేకుండానే నిర్వహించడానికి సహాయపడుతుంది.
ముందంజ భాషా మోడల్ను శిక్షణ ఇవ్వడానికి గణన వనరులు, డేటా, శక్తి, ఇంజినీరింగ్ మీద వందల మిలియన్లు ఖర్చవవచ్చు. అది ఒక పెద్ద సినిమా బడ్జెట్తో సమానం, కానీ ఇక్కడ "నటుడు" ప్రతి ప్రోగ్రామింగ్ భాష మాట్లాడగలడు.
ప్రతి ఆధునిక LLM Transformerపై నిర్మించబడింది. ఇది 2017లో వచ్చిన Attention Is All You Need పేపర్లో పరిచయం చేయబడింది. ప్రధాన ఆవిష్కరణ సెల్ఫ్-అటెన్షన్. ఇన్పుట్లోని ప్రతి పదం మిగతా ప్రతి పదంతో పోలిస్తే ఎంత ముఖ్యమో మోడల్ కొలవడానికి ఇది సహాయపడుతుంది.
సెల్ఫ్-అటెన్షన్ ఎలా పనిచేస్తుంది (సరళీకరించి):
సైన్ ఇన్ చేయండి చర్చలో పాల్గొనడానికి
అటెన్షన్ మధ్యలో ఉన్న గణిత సూత్రం ఇది:
Attention(Q, K, V) = softmax(QK^T / √d) × V
√dతో భాగించడం (Key పరిమాణం యొక్క వర్గమూలం) డాట్ ప్రొడక్ట్స్ చాలా పెద్దవిగా మారకుండా కాపాడుతుంది. అవి పెద్దవైతే softmax ఫంక్షన్ చాలా చిన్న గ్రేడియెంట్లు ఉన్న ప్రాంతాల్లోకి వెళ్లిపోతుంది. ఈ సరళమైన స్కేలింగ్ పద్ధతి లోతైన Transformersను స్థిరంగా శిక్షణ ఇవ్వడానికి సహాయపడిన కీలక ఆలోచనల్లో ఒకటి.
ఇది అనేక అటెన్షన్ హెడ్లలో సమాంతరంగా పునరావృతమవుతుంది. అందువల్ల మోడల్ ఒకేసారి వేర్వేరు రకాల సంబంధాలను పట్టుకోగలదు, ఉదాహరణకు ఒక హెడ్లో వాక్యనిర్మాణం, మరొక హెడ్లో అర్థసంబంధం.
ఒక వాక్యంలో 500 టోకెన్లు ఉంటే, సెల్ఫ్-అటెన్షన్ ప్రతి టోకెన్ను మిగతా ప్రతి టోకెన్తో పోల్చుతుంది. అంటే ప్రతి లేయర్కు 250,000 పోలికలు. ఈ చతురస్ర వ్యయం LLMలు ప్రాసెస్ చేయగల విషయాలపై ఎలా ప్రభావం చూపవచ్చు?
| మోడల్ | సృష్టికర్త | ముఖ్యమైన లక్షణం | |-------|---------|-----------------| | GPT-6 Astra | OpenAI | ముందంజ తార్కికత, కోడింగ్, పరిశోధన, బహుమోడల్ ఇన్పుట్ | | Claude Opus 5.5 | Anthropic | దీర్ఘకాలిక ఏజెంటిక్ కోడింగ్ మరియు జ్ఞాన పని | | Gemini 3.1 Pro | Google DeepMind | అధునాతన తార్కికత, కోడింగ్, బహుమోడల్ సామర్థ్యం | | Llama 4 | Meta | ఓపెన్-వెయిట్, సహజ బహుమోడల్ సామర్థ్యం, దీర్ఘ సందర్భం | | Mistral Large | Mistral AI | సమర్థమైన యూరోపియన్ ప్రత్యామ్నాయం |
ఈ రంగం అసాధారణ వేగంతో మారుతోంది. మీరు ఇది చదివే సమయానికి ఇంకా కొత్త మోడళ్లు వచ్చి ఉండవచ్చు.
ఈ రంగంలో ఒక కీలకమైన తేడా క్లోజ్డ్-సోర్స్ మోడళ్లు (GPT, Claude, Gemini) మరియు ఓపెన్-వెయిట్ మోడళ్లు (Llama, Mistral) మధ్య ఉంటుంది. క్లోజ్డ్-సోర్స్ మోడళ్లలో API మాత్రమే అందుబాటులో ఉంటుంది. ఓపెన్-వెయిట్ మోడళ్లలో మోడల్ వెయిట్లు ప్రజలకు విడుదల చేయబడతాయి. ఓపెన్-వెయిట్ మోడళ్లతో సంస్థలు తమ స్వంత మౌలిక వసతులపై ఇన్ఫరెన్స్ నడపగలవు, నిర్దిష్ట రంగాల కోసం ఫైన్-ట్యూన్ చేయగలవు, మోడల్ ప్రవర్తనను పరిశీలించగలవు. గోప్యత కీలకమైన రంగాలకు ఇవి చాలా ముఖ్యమైన ప్రయోజనాలు.
"ఓపెన్" మోడళ్లు అన్నీ నిజంగా ఓపెన్ సోర్స్ కావు. కొన్ని వెయిట్లను విడుదల చేస్తాయి, కానీ వాణిజ్య వినియోగాన్ని పరిమితం చేస్తాయి లేదా శిక్షణ డేటా మరియు కోడ్ను పంచవు. ప్రొడక్షన్లో ఓపెన్-వెయిట్ మోడల్ను డిప్లాయ్ చేయడానికి ముందు లైసెన్స్ను ఎప్పుడూ తనిఖీ చేయండి.
LLMలు దశల వారీగా నిర్మించబడతాయి:
ప్రీ-ట్రైనింగ్ - మోడల్ అపారమైన టెక్స్ట్ చదివి తదుపరి టోకెన్ను అంచనా వేయడం నేర్చుకుంటుంది. ఈ దశ అత్యంత ఖరీదైనది. దీని ఫలితంగా టెక్స్ట్ పూర్తి చేయగలిగే బేస్ మోడల్ వస్తుంది, కానీ అది ప్రత్యేకంగా సహాయకరంగా ఉండదు.
Supervised fine-tuning (SFT) - సరైన సమాధానాలకు మనుషులు రాసిన ఉదాహరణలు మోడల్కు సూచనలు అనుసరించడం మరియు ప్రశ్నలకు సరిగ్గా సమాధానం ఇవ్వడం నేర్పుతాయి.
RLHF (Reinforcement Learning from Human Feedback) - మానవ రేటర్లు మోడల్ అవుట్పుట్లను ఉత్తమం నుండి చెత్త వరకు ర్యాంక్ చేస్తారు. ఒక రివార్డ్ మోడల్ ఈ ప్రాధాన్యతలను నేర్చుకుంటుంది, ఆ తర్వాత LLM రివార్డ్ను గరిష్ఠం చేసేలా శిక్షణ పొందుతుంది. ఇదే మోడళ్లను సహాయకంగా, హానిలేకుండా, నిజాయితీగా మారుస్తుంది.
LLM శిక్షణలో RLHF యొక్క ప్రధాన ఉద్దేశ్యం ఏమిటి?
మోడళ్లు పరిమాణంలో పెరిగేకొద్దీ, స్పష్టంగా శిక్షణ ఇవ్వని సామర్థ్యాలను అభివృద్ధి చేసుకుంటాయి:
ఈ ఎదిగివచ్చే లక్షణాలు పరిమాణ విస్తరణలో అత్యంత ఆసక్తికరమైన అంశాల్లో ఒకటి. మోడల్ కొన్ని పరిమాణ పరిమితులు దాటిన తర్వాత ఈ సామర్థ్యాలు దాదాపు "ఉచితంగా" వచ్చినట్టు కనిపిస్తాయి.
ప్రారంభ ముందంజ మోడళ్లలో ఈ నమూనా స్పష్టంగా కనిపించింది: అవి కఠినమైన వృత్తిపరమైన పరీక్షలు పాస్ అయ్యేవి, కానీ ప్రాంప్ట్ వాటి బలహీనతలను బయటపెడితే సాధారణ గణితం లేదా లెక్కింపు పనుల్లో కూడా తడబడేవి.
LLMలు శక్తివంతమైనవి, కానీ పరిపూర్ణం కావు:
LLM అవుట్పుట్లలోని ముఖ్యమైన వాస్తవాలను ఎప్పుడూ అధికారిక మూలాలతో ధృవీకరించండి. LLMలను అద్భుతమైన కానీ నమ్మదగని పరిశోధన సహాయకుడిలా చూడండి: చాలా ఉపయోగకరమైనవి, కానీ వాస్తవ విషయాల్లో చివరి మాట కాదు.
LLMలు కొన్నిసార్లు హాల్యూసినేషన్లు ఎందుకు ఉత్పత్తి చేస్తాయి?
ఏళ్ల తరబడి పెద్దది ఎప్పుడూ మంచిదే అన్న నమ్మకం బలంగా ఉండేది. ఎక్కువ పారామీటర్లు, ఎక్కువ డేటా, ఎక్కువ గణన వనరులు పనితీరును క్రమంగా మెరుగుపరుస్తాయని భావించారు. ఈ "స్కేలింగ్ నియమం" GPT-2, GPT-3, GPT-4 తరం మరియు తర్వాతి ముందంజ వ్యవస్థల వరకు ఆశ్చర్యకరంగా బాగా పనిచేసింది.
అయితే, తాజా పరిశోధన ప్రకారం మొత్తం పరిమాణం ఒక్కటితో వచ్చే లాభాలు తగ్గే దశకు మనం చేరుకుంటుండవచ్చు. దృష్టి ఇప్పుడు వీటివైపు మారుతోంది:
లార్జ్ లాంగ్వేజ్ మోడల్స్ కంప్యూటింగ్లో నిజమైన మూలభూత మార్పును సూచిస్తాయి. AIతో సీరియస్గా పని చేసే ఎవరికి అయినా వాటి ఆర్కిటెక్చర్, శిక్షణ పైప్లైన్, పరిమితులు అర్థం చేసుకోవడం ఐచ్చికం కాదు. ఈ రంగం ముందుకు సాగుతున్న కొద్దీ మీకు ఉపయోగపడే పునాది జ్ఞానం ఇదే.
LLM శిక్షణలో ఏ దశ గణనపరంగా అత్యంత ఖరీదైనది?
ఒక LLM న్యాయవాద అర్హత పరీక్ష పాస్ కావచ్చు, కానీ ఒక పదంలో ఉన్న అక్షరాల సంఖ్యను నమ్మదగిన విధంగా లెక్కించలేకపోతే, అది మానవ మేధస్సు మరియు భాషా మోడల్ సామర్థ్యాల మధ్య తేడా గురించి మనకు ఏమి చెబుతుంది?