Esta lição foi traduzida automaticamente para português e ainda não foi revisada por uma pessoa. Se algo parecer estranho, a versão em inglês é a definitiva.
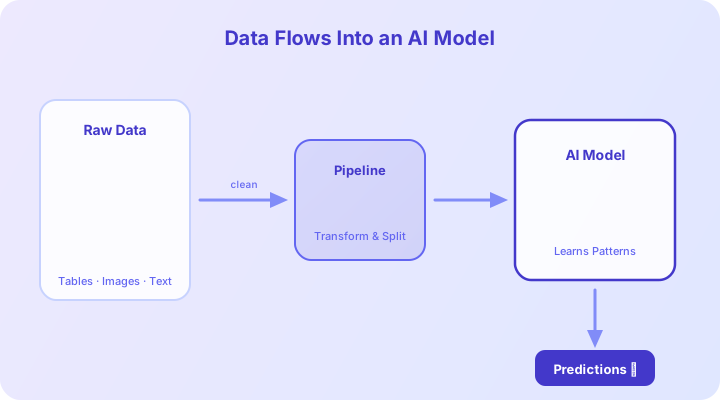
Você já sabe que a IA pode reconhecer rostos, traduzir idiomas e recomendar músicas. Mas o que realmente alimenta tudo isso? Dados. Sem dados, a IA é como um carro sem combustível: ela simplesmente não pode ir a lugar nenhum.
Nesta lição, exploraremos a aparência dos conjuntos de dados, os diferentes tipos de dados que a IA usa e por que a qualidade desses dados é tão importante.
Um conjunto de dados é uma coleção organizada de informações com as quais um sistema de IA aprende. Pense nisso como uma planilha gigante.
O conjunto de dados ImageNet contém mais de 14 milhões de imagens rotuladas manualmente em mais de 20.000 categorias. Os pesquisadores levaram anos e milhares de anotadores humanos para construí-lo.
A IA trabalha com duas grandes categorias de dados:
São dados que se encaixam perfeitamente em tabelas com linhas e colunas - como um registro de transações bancárias ou um registro de paciente hospitalar. Cada campo possui um tipo claro (número, data, categoria).
Exemplos: números de vendas, leituras de sensores, respostas a pesquisas.
São dados que não seguem um formato fixo. Inclui imagens, vídeos, gravações de áudio, e-mails e postagens em mídias sociais. Mais de 80% dos dados mundiais não são estruturados.
Exemplos: fotos no seu telefone, mensagens de voz, artigos de notícias.
Qual das alternativas a seguir é um exemplo de dados não estruturados?
Inicie sessão para participar na discussão
Os humanos podem aprender a reconhecer um cachorro depois de ver apenas algumas fotos. A IA normalmente precisa de milhares – às vezes milhões – de exemplos antes de poder fazer o mesmo. Isso ocorre porque a IA não tem uma compreensão integrada do mundo. Todo conhecimento deve vir dos dados.
Quanto mais variados e representativos os dados, melhor a IA generaliza para novas situações. Um modelo treinado apenas com fotos de golden retrievers pode não conseguir reconhecer um poodle. A diversidade nos dados leva à robustez da IA.
É por isso que as empresas investem pesadamente na coleta, limpeza e curadoria de grandes conjuntos de dados – muitas vezes é a parte mais demorada e cara da construção de um sistema de IA.
A boa notícia é que, uma vez existente um conjunto de dados de alta qualidade, ele pode ser reutilizado e partilhado, acelerando a investigação em todo o mundo.
A IA é tão boa quanto os dados com os quais aprende. Se os dados estiverem confusos, incompletos ou incorretos, a IA produzirá resultados não confiáveis. Este princípio é conhecido como lixo entra, lixo sai (GIGO).
Problemas comuns de qualidade de dados incluem:
Imagine que você está estudando para uma prova, mas faltam metade das páginas do seu livro e algumas respostas no final estão erradas. Quão bem você teria um desempenho? Isso é exatamente o que acontece quando a IA treina com dados de baixa qualidade.
Alguns conjuntos de dados tornaram-se famosos na comunidade de IA:
| Conjunto de dados | O que contém | Tamanho | |--------|-----------------|------| | ImageNet | Fotografias etiquetadas | Mais de 14 milhões de imagens | | Rastreamento comum | Páginas da Web de toda a Internet | Petabytes de texto | | Wikipédia | Artigos da enciclopédia | Mais de 60 milhões de artigos | | MNIST | Dígitos manuscritos (0–9) | 70.000 imagens |
Esses conjuntos de dados estão disponíveis gratuitamente e têm sido usados para treinar alguns dos modelos de IA mais influentes da história.
O que contém o conjunto de dados MNIST?
Antes que a IA possa aprender com os dados, geralmente alguém precisa rotulá-los. Isso significa dizer ao sistema o que cada exemplo representa.
Esse processo é chamado de anotação e geralmente é feito por humanos – às vezes milhares deles trabalhando juntos.
Muitas empresas de IA utilizam plataformas de crowdsourcing onde trabalhadores de todo o mundo rotulam os dados por apenas alguns centavos por item. É um enorme esforço global que a maioria das pessoas nunca vê.
Os dados reflectem o mundo de onde provêm – incluindo os preconceitos do mundo. Quando um conjunto de dados representa excessivamente um grupo ou subrepresenta outro, a IA treinada nele herdará esses desequilíbrios.
Exemplos reais de viés de dados:
O preconceito não é apenas um problema técnico – é um problema social. Cada conjunto de dados carrega as suposições e os pontos cegos das pessoas que o criaram.
Se você treinasse uma IA para recomendar restaurantes, mas apenas fornecesse dados de Londres, ela daria boas recomendações para alguém em Manchester? O que pode dar errado?
Qual é a consequência mais provável de treinar uma IA com base em dados tendenciosos?
A seguir, veremos os algoritmos que realmente processam todos esses dados e os transformam em inteligência.