Esta lição foi traduzida automaticamente para português e ainda não foi revisada por uma pessoa. Se algo parecer estranho, a versão em inglês é a definitiva.
Cada aplicação em larga escala é montada a partir dos mesmos blocos de construção fundamentais. Os entrevistadores não esperam que você invente novas tecnologias - eles querem que você selecione e combine os componentes certos para um determinado problema. Esta lição aborda o kit de ferramentas que você usará em cada entrevista de design.
Basicamente, a web segue um modelo simples: clientes enviam solicitações, servidores as processam e as respostas fluem de volta. Mas os sistemas modernos adicionam camadas entre esses dois endpoints para lidar com escala, confiabilidade e desempenho.
Uma solicitação típica pode passar por: cliente → CDN → balanceador de carga → gateway de API → servidor de aplicativos → cache → banco de dados. Cada camada resolve um problema específico, e entender quando cada camada é necessária separa os candidatos fortes dos medianos.
Nas entrevistas, sempre comece esboçando o fluxo cliente-servidor de alto nível antes de mergulhar nos detalhes. Mostra pensamento estruturado.
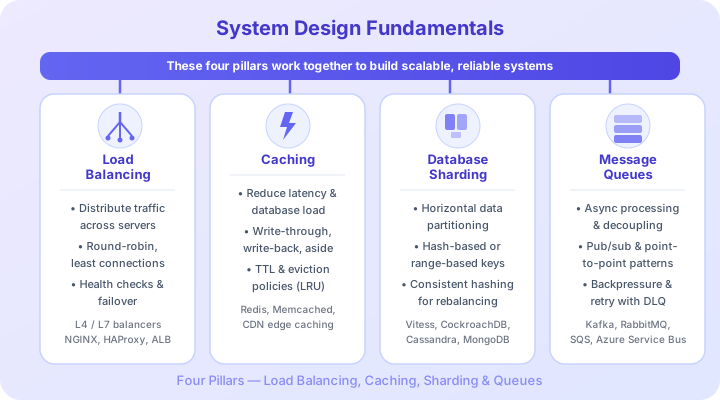
Um único servidor tem capacidade finita. Os balanceadores de carga distribuem solicitações recebidas em vários servidores usando estratégias como:
Os balanceadores de carga também realizam verificações de integridade, removendo automaticamente servidores não íntegros do pool. Em ambientes de nuvem, serviços como AWS ALB ou Azure Front Door lidam com isso de forma transparente.
Um serviço de feed de mídia social recebe 10 vezes mais leituras do que gravações. Qual abordagem de balanceamento de carga garante melhor que os usuários acessem consistentemente o mesmo servidor com cache quente?
O cache armazena dados acessados com frequência mais perto do consumidor. Existe em vários níveis:
Inicie sessão para participar na discussão
| Camada | Exemplo | Latência | |-------|---------|-----| | Cache do navegador | Ativos estáticos, respostas de API | ~0ms | | CDN | Imagens, CSS, arquivos JS | ~10-50ms | | Cache do aplicativo | Redis, Memcached | ~1-5ms | | Cache de banco de dados | Cache de resultados da consulta | ~5-10ms |
Invalidação de cache é notoriamente um dos problemas mais difíceis da computação. Estratégias comuns incluem TTL (time-to-live), write-through (atualizar cache em cada gravação) e cache-aside (o aplicativo gerencia o cache explicitamente).
A famosa citação de Phil Karlton - "Existem apenas duas coisas difíceis na Ciência da Computação: invalidação de cache e nomeação de coisas" - é tão amplamente citada que é praticamente um rito de passagem em entrevistas de design de sistemas.
Escolher o banco de dados certo é uma das decisões de design mais impactantes:
Bancos de dados SQL (PostgreSQL, MySQL) oferecem transações ACID, forte consistência e esquemas estruturados. Eles se destacam quando os dados têm relacionamentos claros e você precisa de consultas complexas com junções.
Bancos de dados NoSQL vêm em vários tipos:
Você está projetando um sistema que armazena perfis de usuário com dados semiestruturados que mudam frequentemente (campos diferentes por tipo de usuário). Qual tipo de banco de dados é mais adequado?
Nem toda operação precisa de uma resposta imediata. As filas de mensagens (RabbitMQ, Apache Kafka, AWS SQS) separam produtores de consumidores, permitindo:
Kafka merece menção especial: não é apenas uma fila, mas um log de eventos distribuído, permitindo arquiteturas orientadas a eventos onde vários consumidores podem processar independentemente o mesmo fluxo de eventos.
| Aspecto | Monólito | Microsserviços | |--------|----------|---------------| | Implantação | Unidade única | Serviços independentes | | Dimensionamento | Dimensione tudo junto | Dimensionar serviços individuais | | Complexidade | Mais simples de começar | Despesas operacionais | | Dados | Banco de dados compartilhado | Banco de dados por serviço |
Comece o monolith, extraia microsserviços quando necessário. A maioria dos entrevistadores aprecia os candidatos que reconhecem que os microsserviços introduzem complexidade de sistema distribuído (falhas de rede, consistência de dados, orquestração de implantação) e nem sempre são a escolha certa.
A Netflix migrou de um monólito para microsserviços ao longo de vários anos. Mas o Shopify – que lida com bilhões em transações – ainda opera um monólito modular. Que fatores podem tornar uma abordagem melhor que a outra para uma determinada empresa?
O teorema CAP afirma que um sistema distribuído pode garantir apenas duas das três propriedades simultaneamente:
Como as partições de rede são inevitáveis em sistemas distribuídos, a verdadeira escolha é entre CP (consistência sobre disponibilidade) e AP (disponibilidade sobre consistência).
Você está projetando um sistema de transações bancárias onde saldos incorretos podem causar perdas financeiras. Qual compromisso da PAC você deve priorizar?
Ao entrar em uma entrevista de design de sistema, siga esta estrutura:
Pense em um sistema que você usa diariamente – Instagram, Uber ou Spotify. Você consegue identificar quais blocos de construção desta lição ela provavelmente usa? Onde ficaria o balanceador de carga? O que seria armazenado em cache? Qual tipo de banco de dados se ajusta ao seu modelo de dados?
A seguir: aplicaremos esses fundamentos para projetar um encurtador de URL do zero.