Visão Computacional - Como a IA aprende a ver o mundo
Esta lição foi traduzida automaticamente para português e ainda não foi revisada por uma pessoa. Se algo parecer estranho, a versão em inglês é a definitiva.
Visão Computacional - Como a IA aprende a ver o mundo
Você olha para uma foto e sabe instantaneamente que ela mostra um cachorro na praia. Para um computador, essa mesma imagem nada mais é do que uma grade gigante de números. Visão computacional é o ramo da IA que ensina as máquinas a extrair significado desses números – e já está remodelando as indústrias ao seu redor.
Como os computadores “vêem”
Quando você olha uma fotografia, seu cérebro reconhece instantaneamente formas, cores e profundidade. Um computador não tem nada dessa intuição. Em vez disso, funciona com números brutos.
Uma imagem digital é uma grade de pixels. Cada pixel armazena valores de cores - normalmente três canais: vermelho, verde e azul (RGB). Uma imagem HD de 1920 × 1080 contém mais de dois milhões de pixels, cada um com três valores variando de 0 a 255. Multiplique-os e até mesmo um único quadro contém milhões de números.
Resolução determina quantos detalhes a grade captura. Resolução mais alta significa mais pixels e detalhes mais ricos - mas também muito mais dados para a IA processar. Uma imagem 4K tem quatro vezes mais pixels de HD, o que significa quatro vezes o custo computacional.
Imagens em tons de cinza possuem apenas um canal (brilho), enquanto alguns formatos especializados - como imagens de satélite ou exames médicos - podem ter dezenas de canais capturando comprimentos de onda invisíveis ao olho humano.
O olho humano pode distinguir cerca de 10 milhões de cores. Uma imagem RGB padrão de 8 bits pode representar mais de 16,7 milhões de combinações de cores exclusivas – mais do que podemos realmente perceber!
Redes Neurais Convolucionais (CNNs)
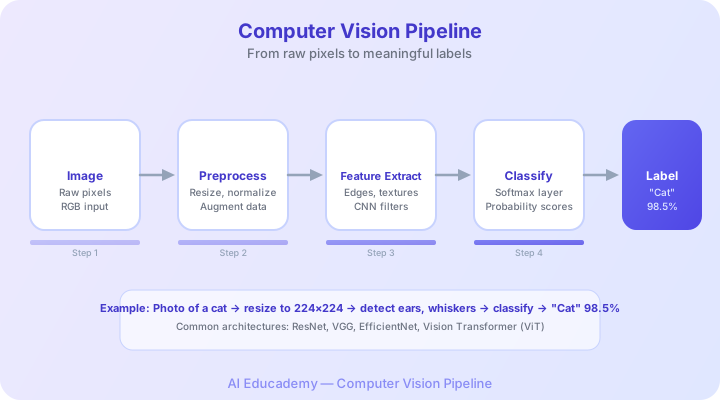
As primeiras tentativas de visão computacional baseavam-se em regras elaboradas à mão - "procure arestas aqui, combine isso modelo lá." Essas abordagens frágeis falharam sempre que o cenário mudou. Uso de sistemas modernos Redes Neurais Convolucionais (CNNs), que aprendem suas próprias regras a partir de milhares de redes rotuladas exemplos.
Pense em uma CNN como uma linha de montagem de detectores de padrões, cada camada construída sobre a anterior:
- Camadas convolucionais deslizam pequenos filtros pela imagem, detectando padrões simples como bordas, cantos e texturas.
- Camadas de pooling reduzem os dados, mantendo apenas os sinais mais importantes e descartando detalhe redundante.
Discussão
Inicie sessão para participar na discussão