AI EducademyAIEducademy
🌳

AI की नींव

🌱
AI Seeds

वास्तविक दुनिया के लिए एआई साक्षरता

🌿
AI Sprouts

बुद्धिमान प्रणालियों के पीछे की नींव

🌳
AI Branches

आज की AI क्षमताओं के साथ निर्माण करें

🏕️
AI Canopy

इंजीनियर विश्वसनीय GenAI सिस्टम

🌲
AI Forest

एआई उत्पादों को जिम्मेदारी से शिप करें

🔨

AI में महारत

✏️
AI Sketch

एआई बिल्डरों के लिए इंजीनियरिंग फाउंडेशन

🪨
AI Chisel

कठिन समस्याओं को हल करने के लिए पैटर्न

⚒️
AI Craft

ऐसे डिज़ाइन सिस्टम जो AI को मापें

💎
AI Polish

एआई युग में संचार करें और नेतृत्व करें

🏆
AI Masterpiece

आपका उत्पादन एआई कैपस्टोन

🚀

करियर रेडी

🚀
इंटरव्यू लॉन्चपैड

एआई इंजीनियरिंग जॉब मार्केट पर नेविगेट करें

🌟
व्यवहारिक इंटरव्यू में महारत

आप कैसे प्रभाव पैदा करते हैं इसकी कहानी बताएं

💻
तकनीकी इंटरव्यू

दबाव में समाधान करें, डिज़ाइन करें और संवाद करें

🤖
AI और ML इंटरव्यू

आधुनिक ML और GenAI साक्षात्कार के लिए तैयारी करें

🏆
ऑफर और उससे आगे

अगला कदम आत्मविश्वासपूर्ण और जानकारीपूर्ण बनाएं

सभी कार्यक्रम देखें→

लैब

7 प्रयोग लोड हुए
🧠न्यूरल नेटवर्क प्लेग्राउंड🤖AI या इंसान?💬प्रॉम्प्ट लैब🎨इमेज जनरेटर😊सेंटिमेंट एनालाइज़र💡चैटबॉट बिल्डर⚖️एथिक्स सिमुलेटर
🎯मॉक इंटरव्यूलैब में जाएँ→
यात्राब्लॉग
🎯
हमारे बारे में

हर जगह, हर किसी के लिए AI शिक्षा सुलभ बनाना

❓
अक्सर पूछे जाने वाले प्रश्न

सामान्य प्रश्नों के उत्तर

🧰
AI टूल्स

हमारे चुने हुए और सुझाए गए टूल्स

✉️
संपर्क

हमसे संपर्क करें

⭐
ओपन सोर्स

GitHub पर सार्वजनिक रूप से निर्मित

मूल्य
सीखना शुरू करें
AI EducademyAIEducademy

© 2026 AI Educademy. सर्वाधिकार सुरक्षित।

सीखें

  • कार्यक्रम
  • पाठ
  • लैब
  • एआई स्टार्टर किट
  • मूल्य

समुदाय

  • GitHub
  • योगदान करें
  • आचार संहिता
  • हमारे बारे में
  • सामान्य प्रश्न

सहायता

  • कॉफ़ी खरीदें ☕
  • सेवा की शर्तें
  • गोपनीयता नीति
  • संपर्क करें
  • Sitemap
AI और इंजीनियरिंग प्रोग्राम›🌿 AI Sprouts›पाठ›डेटासेट और डेटा - AI का ईंधन
📊
AI Sprouts • शुरुआती⏱️ 12 मिनट पढ़ने का समय

डेटासेट और डेटा - AI का ईंधन

लेवल 2 में स्वागत है! 👋

AI Seeds में आपने सीखा कि AI उदाहरणों से सीखता है - जैसे बच्चे तस्वीरों की किताबों से जानवरों को पहचानना सीखते हैं। लेकिन ये उदाहरण कहाँ से आते हैं?

जवाब है डेटा - और यह AI का सबसे महत्वपूर्ण तत्व है। खराब डेटा = खराब AI। बढ़िया डेटा = बढ़िया AI।
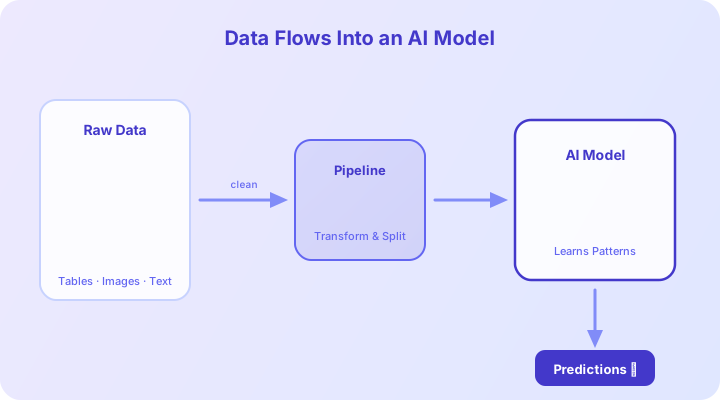
डेटा AI मॉडल में ईंधन की तरह प्रवाहित होता है
डेटा हर AI सिस्टम को चलाने वाला ईंधन है

डेटा क्या है? 🤔

डेटा बस रिकॉर्ड की गई जानकारी है। हर डिजिटल कार्य डेटा बनाता है:

  • 📸 फ़ोटो लेना → इमेज डेटा
  • 💬 मैसेज भेजना → टेक्स्ट डेटा
  • 🎵 गाना बजाना → सुनने का इतिहास
  • 🛒 ऑनलाइन खरीदारी → लेनदेन डेटा
  • 📍 Google मैप्स खोलना → लोकेशन डेटा

AI में हम यह जानकारी इकट्ठा करते हैं, व्यवस्थित करते हैं, और मशीनों को सिखाने के लिए उपयोग करते हैं।


स्ट्रक्चर्ड vs अनस्ट्रक्चर्ड डेटा

📋 स्ट्रक्चर्ड डेटा

डेटा जो पंक्तियों और स्तंभों में फिट होता है - जैसे स्प्रेडशीट।

| नाम | उम्र | शहर | पसंदीदा रंग | |-----|------|------|------------| | आयशा | 14 | लंदन | नीला | | रवि | 16 | हैदराबाद | हरा | | एम्मा | 15 | एम्स्टर्डम | लाल |

🖼️ अनस्ट्रक्चर्ड डेटा

डेटा जो टेबल में फिट नहीं होता - इमेज, वीडियो, ऑडियो, ईमेल, सोशल मीडिया पोस्ट।

🤯

दुनिया का 80% से ज़्यादा डेटा अनस्ट्रक्चर्ड है! फ़ोटो, वीडियो और मैसेज स्प्रेडशीट से बहुत ज़्यादा हैं। आधुनिक डीप लर्निंग इस अव्यवस्थित डेटा को संभालने के लिए ही बनाई गई है।


ट्रेनिंग, वैलिडेशन और टेस्ट डेटा

जब आप परीक्षा की तैयारी करते हैं, तो सिर्फ किताब नहीं पढ़ते - प्रैक्टिस प्रश्न भी हल करते हैं, फिर असली परीक्षा देते हैं। AI भी ऐसा ही करता है:

📚 ट्रेनिंग डेटा (किताब)

सबसे बड़ा हिस्सा - सभी डेटा का 70–80%। AI मॉडल इससे पैटर्न सीखता है।

📝 वैलिडेशन डेटा (प्रैक्टिस प्रश्न)

लगभग 10–15%। ट्रेनिंग के दौरान प्रगति जांचने के लिए।

🎓 टेस्ट डेटा (अंतिम परीक्षा)

बचा हुआ 10–15%। ट्रेनिंग के बाद उपयोग होता है। मॉडल ने यह डेटा कभी नहीं देखा।

from sklearn.model_selection import train_test_split

# विभाजन: 80% ट्रेनिंग, 20% अस्थायी
train_data, temp_data = train_test_split(all_data, test_size=0.2)

# अस्थायी सेट का विभाजन: आधा वैलिडेशन, आधा टेस्ट
val_data, test_data = train_test_split(temp_data, test_size=0.5)

print(f"Training: {len(train_data)}")
print(f"Validation: {len(val_data)}")
print(f"Test: {len(test_data)}")
🤔
Think about it:

हम मॉडल को उसी डेटा पर क्यों नहीं टेस्ट कर सकते जिस पर उसने ट्रेनिंग ली? क्योंकि यह ऐसा होगा जैसे छात्र को पहले से परीक्षा के प्रश्न दे दें - पूरे नंबर मिलेंगे लेकिन असली समझ नहीं आएगी।

16 का पाठ 10% पूर्ण
←प्रोग्राम पर वापस
जारी रखें: एल्गोरिदम समझाए गए - AI की रेसिपी→

चर्चा

साइन इन करें चर्चा में शामिल होने के लिए

इस पाठ में संपादन सुझाएं

डेटा बायस - यह क्यों मायने रखता है ⚖️

AI उतना ही निष्पक्ष है जितना वह डेटा जिससे वह सीखता है।

अगर आप फ़ेशियल रिकग्निशन सिस्टम को ज़्यादातर गोरी त्वचा वाले लोगों की फ़ोटो से ट्रेन करें, तो यह काली त्वचा वाले चेहरों पर खराब काम करेगा।

बायस के उदाहरण:

  • 🏥 हेल्थकेयर AI पुरुषों के डेटा पर ट्रेन - महिलाओं में गलत डायग्नोसिस
  • 💼 हायरिंग AI ऐतिहासिक रिज्यूमे पर ट्रेन - महिला उम्मीदवारों को नुकसान
  • 🚗 सेल्फ-ड्राइविंग कारें धूप वाले कैलिफोर्निया में ट्रेन - बारिश और बर्फ में दिक्कत
💡

बायस हमेशा स्पष्ट नहीं होता। अगर आपके डेटासेट में 90% अंग्रेज़ी टेक्स्ट है, तो आपकी AI अंग्रेज़ी में उत्कृष्ट लेकिन हिंदी, तेलुगू या डच में कमज़ोर होगी। हमेशा पूछें: "इस डेटा में कौन गायब है?"


प्रसिद्ध डेटासेट 🌍

✍️ MNIST

  • क्या: हस्तलिखित अंकों (0–9) की 70,000 इमेज
  • महत्व: मशीन लर्निंग का "Hello दुनिया"

🖼️ ImageNet

  • क्या: 20,000+ श्रेणियों में 14 मिलियन से ज़्यादा लेबल की गई इमेज
  • महत्व: ImageNet प्रतियोगिता (2010–2017) ने इमेज रिकग्निशन को बहुत आगे बढ़ाया

🌐 आम Crawl

  • क्या: 2008 से एकत्र पेटाबाइट्स वेब डेटा
  • महत्व: GPT जैसे बड़े भाषा मॉडल इसी से संचालित होते हैं

🗣️ LibriSpeech

  • क्या: 1,000 घंटे पढ़ी गई अंग्रेज़ी स्पीच
  • महत्व: वॉइस असिस्टेंट जैसे स्पीच रिकग्निशन सिस्टम को ट्रेन करने में उपयोग
🤯

पूरा MNIST डेटासेट 15 MB से कम है - एक स्मार्टफोन फ़ोटो से भी छोटा! फिर भी इसने हज़ारों AI करियर शुरू किए।


प्रैक्टिस: डेटासेट एक्सप्लोर करना 🔬

प्रसिद्ध Iris डेटासेट एक्सप्लोर करें - 4 विशेषताओं वाले 150 फूलों की माप।

import pandas as pd
from sklearn.datasets import load_iris

# डेटासेट लोड करें
iris = load_iris()
df = pd.DataFrame(iris.data, columns=iris.feature_names)
df['species'] = [iris.target_names[t] for t in iris.target]

# बुनियादी अन्वेषण
print("Shape:", df.shape)
print("\nपहली 5 पंक्तियाँ:")
print(df.head())

print("\nप्रजातियों की गिनती:")
print(df['species'].value_counts())

print("\nबुनियादी आंकड़े:")
print(df.describe())

डेटासेट एक्सप्लोर करते समय हमेशा पूछें:

  1. कितने सैंपल हैं? (पंक्तियाँ)
  2. कितनी विशेषताएं हैं? (स्तंभ)
  3. क्या क्लासेस संतुलित हैं?
  4. क्या कोई मान गायब हैं?
  5. संख्याएं कैसी दिखती हैं? (रेंज, औसत, फैलाव)

सारांश 🎯

  1. डेटा रिकॉर्ड की गई जानकारी है - फ़ोटो, मैसेज, क्लिक
  2. स्ट्रक्चर्ड डेटा टेबल में फिट होता है; अनस्ट्रक्चर्ड डेटा नहीं
  3. डेटा को ट्रेनिंग, वैलिडेशन और टेस्ट सेट में बांटा जाता है
  4. डेटा बायस अनुचित AI बनाता है - पूछें कौन गायब है
  5. MNIST, ImageNet और आम Crawl जैसे डेटासेट आज के AI को शक्ति देते हैं
  6. मॉडल बनाने से पहले हमेशा डेटा एक्सप्लोर करें

आगे क्या? 🚀

अब आप जानते हैं AI को क्या शक्ति देता है। अगले पाठ में हम एल्गोरिदम जानेंगे - वे स्टेप-बाय-स्टेप रेसिपी जो डेटा को बुद्धिमान निर्णयों में बदलती हैं!