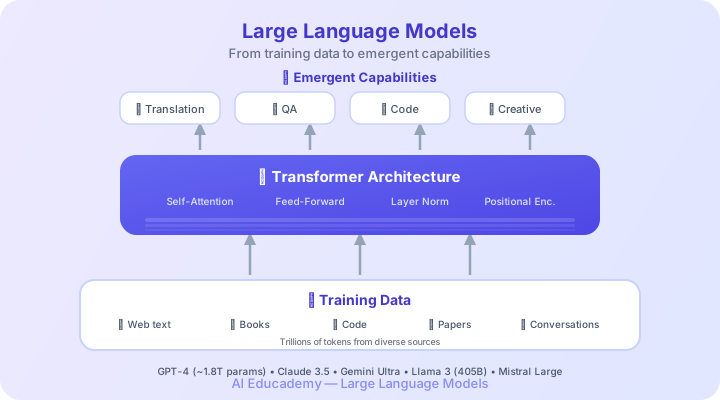
लार्ज लैंग्वेज मॉडल ने मूल रूप से बदल दिया है कि मशीनें टेक्स्ट, कोड और तर्क के साथ क्या कर सकती हैं। इस पाठ में हम पर्दा हटाकर देखेंगे कि वे कैसे काम करते हैं, वे इतने शक्तिशाली क्यों हैं और कहाँ वे अब भी कम पड़ते हैं।
लार्ज लैंग्वेज मॉडल एक न्यूरल नेटवर्क है जिसे अनुक्रम में अगले टोकन की भविष्यवाणी करने के लिए विशाल मात्रा के टेक्स्ट पर प्रशिक्षित किया जाता है। “लार्ज” से आशय पैरामीटरों की संख्या से है: सीखने योग्य वेट, जो प्रशिक्षण डेटा से पैटर्न एन्कोड करते हैं।
ये मॉडल किताबों, वेबसाइटों, कोड रिपॉज़िटरी और अकादमिक पेपरों से लिए गए सैकड़ों बिलियन शब्दों पर प्रशिक्षित होते हैं। डेटा और पैरामीटर का यह विशाल पैमाना ही LLM को उनकी उल्लेखनीय बहुमुखी क्षमता देता है।
शब्द नहीं, टोकन: LLM पूरे शब्द प्रोसेस नहीं करते। वे टोकन पर काम करते हैं, जो उप-शब्द इकाइयाँ होती हैं। understanding शब्द under + stand + ing में टूट सकता है। सामान्य अंग्रेज़ी शब्द औसतन लगभग 1.3 टोकन होता है। यह टोकनाइज़ेशन योजना मॉडलों को दुर्लभ शब्द, तकनीकी शब्दावली और कई भाषाएँ असंभव रूप से बड़ी शब्दावली के बिना संभालने देती है।
फ़्रंटियर भाषा मॉडल को प्रशिक्षित करने में कम्प्यूट, डेटा, ऊर्जा और इंजीनियरिंग में सैकड़ों मिलियन खर्च हो सकते हैं। यह लगभग किसी बड़ी फ़िल्म के बजट जैसा है, बस “अभिनेता” हर प्रोग्रामिंग भाषा बोल सकता है।
हर आधुनिक LLM ट्रांसफ़ॉर्मर पर बना है, जिसे 2017 के पेपर Attention Is All You Need में प्रस्तुत किया गया था। मुख्य नवाचार सेल्फ-अटेंशन है: ऐसा तंत्र जो मॉडल को यह तौलने देता है कि इनपुट में हर शब्द दूसरे हर शब्द की तुलना में कितना महत्वपूर्ण है।
साइन इन करें चर्चा में शामिल होने के लिए
सेल्फ-अटेंशन कैसे काम करता है (सरल रूप में):
अटेंशन के केंद्र में गणितीय सूत्र है:
Attention(Q, K, V) = सॉफ़्टमैक्स(QK^T / √d) × V
√d (की आयाम का वर्गमूल) से भाग देने से डॉट प्रोडक्ट बहुत बड़े नहीं होते, वरना सॉफ़्टमैक्स फ़ंक्शन बेहद छोटे ग्रेडिएंट वाले क्षेत्रों में चला जाएगा। यह सरल स्केलिंग तरकीब उन प्रमुख अंतर्दृष्टियों में से थी जिसने गहरे ट्रांसफ़ॉर्मर का प्रशिक्षण स्थिर बनाया।
यह कई अटेंशन हेड में समानांतर दोहराया जाता है, जिससे मॉडल अलग-अलग प्रकार के संबंध एक साथ पकड़ सकता है: एक हेड में वाक्य रचना, दूसरे में अर्थ।
अगर वाक्य में 500 टोकन हैं, तो सेल्फ-अटेंशन हर टोकन की हर दूसरे से तुलना करता है। यह प्रति लेयर 250,000 तुलनाएँ हैं। यह चतुर्भुजीय लागत LLM क्या प्रोसेस कर सकते हैं, इस पर कैसे असर डाल सकती है?
| मॉडल | निर्माता | उल्लेखनीय विशेषता | |-------|---------|-----------------| | GPT-6 Astra | OpenAI | फ़्रंटियर तर्क, कोडिंग, शोध और मल्टीमॉडल इनपुट | | Claude Opus 5.5 | Anthropic | लंबी चलने वाली एजेंटिक कोडिंग और ज्ञान कार्य | | Gemini 3.1 Pro | Google DeepMind | उन्नत तर्क, कोडिंग और मल्टीमॉडैलिटी | | Llama 4 | Meta | ओपन-वेट, नेटिव मल्टीमॉडैलिटी, लंबा संदर्भ | | Mistral Large | Mistral AI | कुशल यूरोपीय विकल्प |
यह क्षेत्र असाधारण तेज़ी से चलता है। जब तक आप यह पढ़ेंगे, नए मॉडल शायद पहले ही आ चुके हों।
इस परिदृश्य में एक महत्वपूर्ण अंतर क्लोज़्ड-सोर्स मॉडलों (GPT, Claude, Gemini) और ओपन-वेट मॉडलों (Llama, Mistral) के बीच है। क्लोज़्ड-सोर्स मॉडलों में केवल API उपलब्ध होता है, जबकि ओपन-वेट मॉडलों में मॉडल वेट सार्वजनिक रूप से जारी होते हैं। ओपन-वेट मॉडल संगठनों को अपनी इन्फ़्रास्ट्रक्चर पर इन्फ़रेंस चलाने, विशिष्ट डोमेन के लिए फ़ाइन-ट्यून करने और मॉडल व्यवहार जाँचने देते हैं। गोपनीयता-संवेदनशील उद्योगों के लिए ये लाभ बहुत मायने रखते हैं।
हर “ओपन” मॉडल सचमुच ओपन सोर्स नहीं होता। कुछ वेट जारी करते हैं लेकिन व्यावसायिक उपयोग सीमित करते हैं या प्रशिक्षण डेटा और कोड साझा नहीं करते। ओपन-वेट मॉडल को प्रोडक्शन में डिप्लॉय करने से पहले हमेशा लाइसेंस जाँचें।
LLM चरणों में बनाए जाते हैं:
प्री-ट्रेनिंग - मॉडल विशाल मात्रा का टेक्स्ट पढ़ता है और अगला टोकन भविष्यवाणी करना सीखता है। यह चरण अत्यंत महँगा होता है और ऐसा बेस मॉडल देता है जो टेक्स्ट पूरा कर सकता है लेकिन विशेष रूप से सहायक नहीं होता।
Supervised फ़ाइन-ट्यूनिंग (SFT) - आदर्श प्रतिक्रियाओं के मानव-लिखित उदाहरण मॉडल को निर्देशों का पालन करना और प्रश्नों का ठीक उत्तर देना सिखाते हैं।
RLHF (Reinforcement Learning from Human Feedback) - मानव रेटर मॉडल आउटपुट को सर्वश्रेष्ठ से सबसे खराब तक रैंक करते हैं। रिवॉर्ड मॉडल ये प्राथमिकताएँ सीखता है, और LLM को रिवॉर्ड अधिकतम करने के लिए प्रशिक्षित किया जाता है। यही मॉडल को सहायक, अहानिकर और ईमानदार बनाता है।
LLM प्रशिक्षण में RLHF का प्राथमिक उद्देश्य क्या है?
जैसे-जैसे मॉडल स्केल होते हैं, वे ऐसी क्षमताएँ विकसित करते हैं जिनका स्पष्ट प्रशिक्षण नहीं दिया गया था:
ये उभरते गुण स्केलिंग के सबसे रोचक पहलुओं में से हैं: ऐसी क्षमताएँ जो मॉडल के कुछ आकार सीमाएँ पार करने पर लगभग “मुफ़्त” दिखाई देती हैं।
शुरुआती फ़्रंटियर मॉडलों ने पैटर्न साफ़ दिखाया: वे कठिन पेशेवर परीक्षाएँ पास कर सकते थे, लेकिन जब प्रॉम्प्ट उनकी कमजोरी उजागर करता था तो सरल अंकगणित या गिनती कार्यों पर अटक जाते थे।
LLM शक्तिशाली हैं लेकिन पूर्णता से दूर हैं:
LLM आउटपुट से महत्वपूर्ण तथ्य हमेशा प्रामाणिक स्रोतों से सत्यापित करें। LLM को शानदार लेकिन अविश्वसनीय शोध सहायक मानें: अत्यंत उपयोगी, लेकिन तथ्य के मामलों में कभी अंतिम शब्द नहीं।
LLM कभी-कभी हैलुसिनेशन क्यों बनाते हैं?
वर्षों तक प्रमुख विश्वास यह था कि बड़ा हमेशा बेहतर है। अधिक पैरामीटर, अधिक डेटा और अधिक कम्प्यूट प्रदर्शन को लगातार सुधारेंगे। यह “स्केलिंग लॉ” GPT-2, GPT-3, GPT-4 पीढ़ी और बाद के फ़्रंटियर सिस्टम तक उल्लेखनीय रूप से सही रहा।
हालाँकि हालिया शोध बताता है कि केवल कच्चे स्केल पर घटते प्रतिफल आने लग सकते हैं। ध्यान अब इन बातों की ओर खिसक रहा है:
लार्ज लैंग्वेज मॉडल कंप्यूटिंग में वास्तविक प्रतिमान बदलाव हैं। उनकी आर्किटेक्चर, प्रशिक्षण पाइपलाइन और सीमाओं को समझना AI के साथ गंभीरता से काम करने वाले किसी भी व्यक्ति के लिए वैकल्पिक नहीं है। यह बुनियादी ज्ञान है जो क्षेत्र के आगे बढ़ने पर लगातार काम आएगा।
LLM प्रशिक्षण का कौन सा चरण कम्प्यूटेशन की दृष्टि से सबसे महँगा है?
अगर LLM बार परीक्षा पास कर सकता है लेकिन किसी शब्द में अक्षरों की संख्या भरोसेमंद ढंग से नहीं गिन सकता, तो यह मानव बुद्धिमत्ता और भाषा मॉडल क्षमताओं के अंतर के बारे में क्या बताता है?