कंप्यूटर विज़न - AI दुनिया को देखना कैसे सीखता है
कंप्यूटर विज़न - AI दुनिया को देखना कैसे सीखता है
आप किसी फ़ोटो पर नज़र डालते हैं और तुरंत समझ जाते हैं कि उसमें समुद्र तट पर एक कुत्ता है। कंप्यूटर के लिए वही छवि संख्याओं की एक विशाल ग्रिड से अधिक कुछ नहीं है। कंप्यूटर विज़न AI की वह शाखा है जो मशीनों को उन संख्याओं से अर्थ निकालना सिखाती है, और यह आपके आसपास के उद्योगों को पहले ही बदल रही है।
कंप्यूटर कैसे "देखते" हैं
जब आप किसी फ़ोटोग्राफ़ को देखते हैं, तो आपका मस्तिष्क आकार, रंग और गहराई तुरंत पहचान लेता है। कंप्यूटर के पास ऐसी सहज समझ नहीं होती। इसके बजाय, वह कच्ची संख्याओं के साथ काम करता है।
डिजिटल छवि पिक्सेल की ग्रिड होती है। हर पिक्सेल रंग मान रखता है, आम तौर पर तीन चैनल: लाल, हरा और नीला (RGB)। 1920 × 1080 HD छवि में बीस लाख से अधिक पिक्सेल होते हैं, और हर पिक्सेल में 0 से 255 तक के तीन मान होते हैं। इन्हें मिलाकर एक ही फ़्रेम में लाखों संख्याएँ बन जाती हैं।
रिज़ॉल्यूशन तय करता है कि ग्रिड कितना विवरण पकड़ती है। अधिक रिज़ॉल्यूशन का अर्थ है अधिक पिक्सेल और अधिक समृद्ध विवरण, लेकिन AI को संसाधित करने के लिए कहीं अधिक डेटा भी। 4K छवि में HD की तुलना में चार गुना पिक्सेल होते हैं, यानी चार गुना कम्प्यूटेशनल लागत।
ग्रेस्केल छवियों में केवल एक चैनल (चमक) होता है, जबकि कुछ विशेष प्रारूपों में, जैसे उपग्रह इमेजरी या मेडिकल स्कैन, दर्जनों चैनल हो सकते हैं जो मानव आँख से अदृश्य तरंगदैर्ध्य को पकड़ते हैं।
मानव आँख लगभग 1 करोड़ रंगों में अंतर कर सकती है। मानक 8-बिट RGB छवि 1 करोड़ 67 लाख से अधिक अनोखे रंग संयोजन दिखा सकती है, यानी हम जितना वास्तव में देख सकते हैं उससे भी अधिक।
कन्वोल्यूशनल न्यूरल नेटवर्क (CNNs)
कंप्यूटर विज़न के शुरुआती प्रयास हाथ से बनाए नियमों पर निर्भर थे: "यहाँ किनारे खोजें, वहाँ इस टेम्पलेट से मिलान करें।" दृश्य बदलते ही ये भंगुर तरीके असफल हो जाते थे। आधुनिक प्रणालियाँ कन्वोल्यूशनल न्यूरल नेटवर्क (CNNs) का उपयोग करती हैं, जो हज़ारों लेबल किए गए उदाहरणों से अपने नियम स्वयं सीखती हैं।
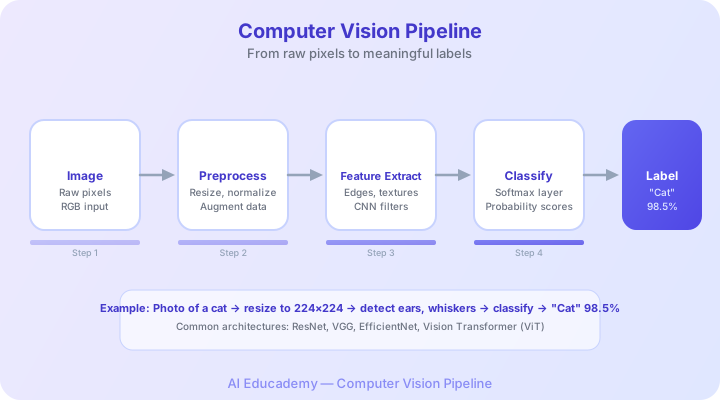
CNN को पैटर्न डिटेक्टरों की असेंबली लाइन की तरह समझें, जहाँ हर परत पिछली परत पर आगे निर्माण करती है:
- कन्वोल्यूशनल परतें छवि पर छोटे फ़िल्टर सरकाती हैं और किनारे, कोने तथा बनावट जैसे सरल पैटर्न पहचानती हैं।
- पूलिंग परतें डेटा को छोटा करती हैं, केवल सबसे महत्वपूर्ण संकेत रखती हैं और अनावश्यक विवरण हटाती हैं।
- गहरी कन्वोल्यूशनल परतें उन सरल पैटर्नों को जोड़कर आँखों, पहियों और अक्षरों जैसी अधिक जटिल विशेषताएँ बनाती हैं।
चर्चा
साइन इन करें चर्चा में शामिल होने के लिए