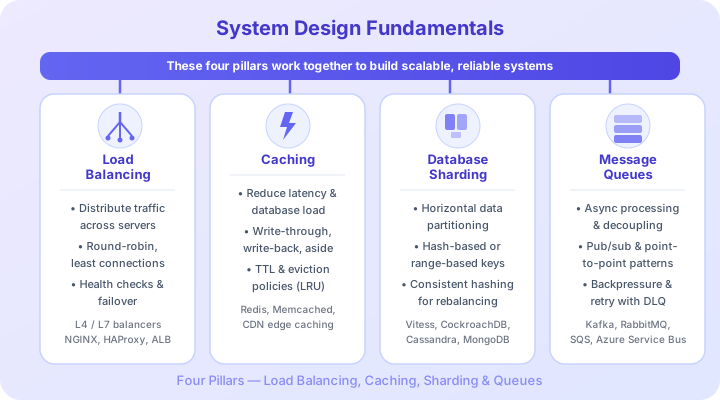
Chaque application à grande échelle est construite à partir des mêmes briques fondamentales. Les recruteurs ne s'attendent pas à ce que vous inventiez une nouvelle technologie - ils veulent voir que vous savez sélectionner et combiner les bons composants pour un problème donné. Cette leçon couvre la boîte à outils que vous utiliserez dans chaque entretien de design.
À la base, le web suit un modèle simple : les clients envoient des requêtes, les servers les traitent, et les réponses reviennent. Mais les systèmes modernes ajoutent des couches entre ces deux points pour gérer le scale, la fiabilité et la performance.
Une requête typique peut traverser : client → CDN → load balancer → API gateway → application server → cache → database. Chaque couche résout un problème spécifique, et comprendre quand chaque couche est nécessaire distingue les bons candidats des moyens.
En entretien, commencez toujours par esquisser le flux client-server de haut niveau avant d'entrer dans les détails. Cela démontre une réflexion structurée.
Un server unique a une capacité limitée. Les load balancers distribuent les requêtes entrantes sur plusieurs servers grâce à des stratégies comme :
Les load balancers effectuent aussi des health checks, retirant automatiquement les servers défaillants du pool. Dans les environnements cloud, des services comme AWS ALB ou Azure Front Door gèrent cela de manière transparente.
Un service de fil d'actualité reçoit 10 fois plus de lectures que d'écritures. Quelle approche de load balancing garantit le mieux que les utilisateurs atteignent systématiquement le même server avec un cache chaud ?
Le caching stocke les données fréquemment consultées au plus près du consommateur. Il existe à plusieurs niveaux :
Connectez-vous pour rejoindre la discussion
| Couche | Exemple | Latency | |--------|---------|---------| | Browser cache | Assets statiques, réponses API | ~0ms | | CDN | Images, fichiers CSS, JS | ~10-50ms | | Application cache | Redis, Memcached | ~1-5ms | | Database cache | Cache des résultats de requêtes | ~5-10ms |
La cache invalidation est célèbre pour être l'un des problèmes les plus difficiles en informatique. Les stratégies courantes incluent le TTL (time-to-live), le write-through (mise à jour du cache à chaque écriture) et le cache-aside (l'application gère le cache explicitement).
La célèbre citation de Phil Karlton - « Il n'y a que deux choses difficiles en informatique : la cache invalidation et nommer les choses » - est tellement citée qu'elle est devenue un passage obligé dans les entretiens de system design.
Choisir la bonne database est l'une des décisions de design les plus déterminantes :
Les SQL databases (PostgreSQL, MySQL) offrent des transactions ACID, une strong consistency et des schemas structurés. Elles excellent quand les données ont des relations claires et que des requêtes complexes avec des jointures sont nécessaires.
Les NoSQL databases se déclinent en plusieurs catégories :
Vous concevez un système qui stocke des profils utilisateurs avec des données semi-structurées qui changent fréquemment (des champs différents selon le type d'utilisateur). Quel type de database convient le mieux ?
Toutes les opérations n'exigent pas une réponse immédiate. Les message queues (RabbitMQ, Apache Kafka, AWS SQS) découplent les producteurs des consommateurs, permettant :
Kafka mérite une mention spéciale : ce n'est pas qu'une simple queue mais un distributed event log, permettant des architectures event-driven où plusieurs consommateurs peuvent traiter indépendamment le même flux d'événements.
| Aspect | Monolith | Microservices | |--------|----------|---------------| | Deployment | Unité unique | Services indépendants | | Scaling | Tout est scalé ensemble | Scaling par service | | Complexité | Plus simple au départ | Overhead opérationnel | | Données | Database partagée | Database par service |
Commencez par un monolith, extrayez des microservices quand c'est nécessaire. La plupart des recruteurs apprécient les candidats qui reconnaissent que les microservices introduisent une complexité de système distribué (pannes réseau, cohérence des données, orchestration du deployment) et ne sont pas toujours le bon choix.
Netflix a migré d'un monolith vers des microservices sur plusieurs années. Mais Shopify - qui traite des milliards en transactions - fonctionne toujours sur un monolith modulaire. Quels facteurs pourraient rendre une approche meilleure que l'autre pour une entreprise donnée ?
Le CAP theorem stipule qu'un système distribué ne peut garantir simultanément que deux des trois propriétés suivantes :
Puisque les network partitions sont inévitables dans les systèmes distribués, le vrai choix se fait entre CP (consistency plutôt qu'availability) et AP (availability plutôt que consistency).
Vous concevez un système de transactions bancaires où des soldes incorrects pourraient entraîner des pertes financières. Quel compromis CAP devez-vous privilégier ?
Lors d'un entretien de system design, suivez cette structure :
Pensez à un système que vous utilisez quotidiennement - Instagram, Uber ou Spotify. Pouvez-vous identifier quelles briques de cette leçon il utilise probablement ? Où se situerait le load balancer ? Qu'est-ce qui serait en cache ? Quel type de database conviendrait à son modèle de données ?
Prochaine leçon : nous appliquerons ces fondamentaux pour concevoir un URL shortener à partir de zéro.