AI EducademyAIEducademy
🌳

KI-Grundlagen

🌱
AI Seeds

KI-Kompetenz für die reale Welt

🌿
AI Sprouts

Die Grundlagen intelligenter Systeme

🌳
AI Branches

Bauen Sie mit den heutigen KI-Funktionen

🏕️
AI Canopy

Entwickeln Sie zuverlässige GenAI-Systeme

🌲
AI Forest

Versenden Sie KI-Produkte verantwortungsbewusst

🔨

KI-Meisterschaft

✏️
AI Sketch

Technische Grundlagen für KI-Entwickler

🪨
AI Chisel

Muster zur Lösung schwierigerer Probleme

⚒️
AI Craft

Entwerfen Sie Systeme, die KI skalieren

💎
AI Polish

Kommunizieren und führen Sie im KI-Zeitalter

🏆
AI Masterpiece

Der Schlussstein Ihrer Produktions-KI

🚀

Karrierebereit

🚀
Interview-Startrampe

Navigieren Sie durch den Arbeitsmarkt für KI-Ingenieure

🌟
Verhaltensinterview-Meisterschaft

Erzählen Sie die Geschichte, wie Sie Wirkung erzielen

💻
Technische Interviews

Unter Druck lösen, entwerfen und kommunizieren

🤖
AI- & ML-Interviews

Bereiten Sie sich auf moderne ML- und GenAI-Interviews vor

🏆
Angebot & Karriere

Machen Sie einen selbstbewussten und informierten nächsten Schritt

Alle Programme anzeigen→

Labor

7 Experimente geladen
🧠Neuronales Netz Spielplatz🤖KI oder Mensch?💬Prompt Labor🎨Bildgenerator😊Stimmungsanalyse💡Chatbot-Baukasten⚖️Ethik-Simulator
🎯ProbeinterviewLabor betreten→
LernreiseArtikel
🎯
Über uns

KI-Bildung für alle zugänglich machen, überall

❓
Häufige Fragen

Häufige Fragen beantwortet

🧰
KI-Tools

Sorgfältig ausgewählte Tools, die wir nutzen und empfehlen

✉️
Kontakt

Nehmen Sie Kontakt mit uns auf

⭐
Quelloffen

Öffentlich auf GitHub entwickelt

Preise
Loslegen
AI EducademyAIEducademy

© 2026 AI Educademy. Alle Rechte vorbehalten.

Lernen

  • Programme
  • Lektionen
  • Labor
  • KI-Starterkit
  • Preise

Gemeinschaft

  • GitHub
  • Mitwirken
  • Verhaltenskodex
  • Über uns
  • Häufige Fragen

Unterstützung

  • Kauf mir einen Kaffee ☕
  • Nutzungsbedingungen
  • Datenschutzerklärung
  • Kontakt
  • Sitemap
KI & Engineering Programme›🌲 AI Forest›Lektionen›KI-Produkte bauen - vom Prototyp bis zur Produktion
🚀
AI Forest • Experte⏱️ 20 Min. Lesezeit

KI-Produkte bauen - vom Prototyp bis zur Produktion

🤖

Diese Lektion wurde automatisch ins Deutsche übersetzt und noch nicht von einem Menschen geprüft. Falls etwas seltsam klingt, gilt die englische Fassung.

KI-Produkte entwickeln

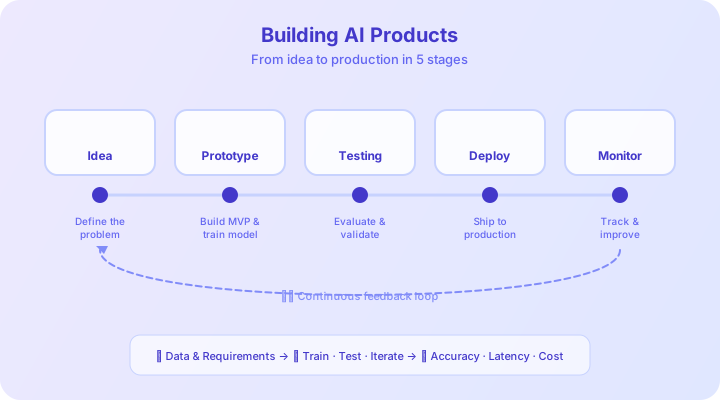
Die meisten KI-Projekte schaffen es nie in die Produktion. Die Lücke zwischen einem funktionierenden Notebook und einem zuverlässigen Produkt ist enorm - von Infrastruktur, Überwachung, Teamprozessen bis hin zum Kostenmanagement. Diese Lektion deckt alles ab, was Sie brauchen, um diese Lücke erfolgreich zu schließen.

Ist KI die richtige Lösung?

Bevor Sie eine einzige Codezeile schreiben, stellen Sie die wichtigste Frage in der KI-Produktentwicklung: Braucht dieses Problem tatsächlich KI? Die Antwort lautet häufiger „Nein“, als Sie denken.

KI ist die richtige Wahl, wenn:

  • Das Problem betrifft die Mustererkennung im großen Maßstab (Betrugserkennung, Bildklassifizierung).
  • Die Regeln sind zu komplex oder zu zahlreich, um sie manuell zu kodieren
  • Die Daten sind verfügbar, von hoher Qualität und repräsentativ für reale Bedingungen
  • Eine probabilistische Antwort (90 % Konfidenz) ist akzeptabel
  • Der Wert der Automatisierung übersteigt die Kosten für den Aufbau und die Wartung des Systems erheblich

KI ist die falsche Wahl, wenn:

  • Einfache Regeln oder Heuristiken lösen das Problem zuverlässig
  • Ihnen fehlen ausreichende Trainingsdaten
  • Entscheidungen erfordern 100 % Genauigkeit mit vollständiger Erklärbarkeit (einige regulatorische Kontexte)
  • Die Wartungskosten eines ML-Systems überwiegen den Nutzen
💡

Die 10x-Regel: Wenn KI nicht mindestens eine 10-fache Verbesserung gegenüber der Nicht-KI-Alternative in Bezug auf Geschwindigkeit, Genauigkeit oder Kosten liefert, lohnt sich die betriebliche Komplexität der Wartung eines ML-Systems selten.

Das richtige Modell auswählen

Nicht jedes Problem erfordert ein großes Sprachmodell. Die Wahl des falschen Modelltyps ist einer der teuersten Fehler bei der KI-Produktentwicklung. Passen Sie das Werkzeug an die Aufgabe an:

| Problemtyp | Bester Ansatz | Beispiel | |---|---|---| | Tabellarische Vorhersage | Gradientenverstärkte Bäume (XGBoost, LightGBM) | Abwanderungsvorhersage, Preisgestaltung | | Bildaufgaben | CNNs oder Vision Transformer | Qualitätsprüfung, OCR | | Textklassifizierung | Fein abgestimmtes BERT oder kleinere LLMs | Stimmungsanalyse, Routing | | Generativer Text | LLMs (GPT, Claude, Llama) | Chatbots, Content-Generierung | | Zeitreihe | Prophet, N-BEATS oder zeitliche CNNs | Nachfrageprognose |

🧠Kurzer Check

Welcher Ansatz ist für eine tabellarische Abwanderungsvorhersageaufgabe mit 50.000 Zeilen strukturierter Daten normalerweise am effektivsten?

Lektion 1 von 100% abgeschlossen
←Zurück zum Programm
Weiter: Das Open-Source-KI-Ökosystem - Tools, Modelle und Communities→

Diskussion

Anmelden um an der Diskussion teilzunehmen

Bearbeitung vorschlagen

Schnelles Prototyping: Der 3-Tage-Sprint

Die Geschwindigkeit der Iteration übertrifft jedes Mal die Perfektion. Teams, die Monate damit verbringen, vor der Validierung aufzubauen, verschwenden Ressourcen für Annahmen. Nutzen Sie dieses Framework, um Ideen schnell zu validieren:

Tag 1 - Umfang und Daten. Definieren Sie die einzelne Metrik, die zählt. Das ist nicht verhandelbar - ohne eine klare Erfolgskennzahl können Sie nichts bewerten. Sammeln oder simulieren Sie den minimal brauchbaren Datensatz. Reinigen Sie es nicht perfekt - gerade genug, um verwendbar zu sein.

Tag 2 - Erstellen und testen. Verwenden Sie ein vorhandenes Modell oder eine vorhandene API. Binden Sie es in eine minimale Schnittstelle ein (Streamlit, Gradio oder eine einfache API). Holen Sie sich etwas, mit dem ein Mensch interagieren kann.

Tag 3 - Validieren. Stellen Sie es echten Benutzern oder Stakeholdern vor - nicht Kollegen, die höflich sein werden, sondern Menschen, die tatsächlich für die Lösung bezahlen würden. Messen Sie sich anhand Ihrer Erfolgskennzahl. Entscheiden Sie: töten, umschwenken oder investieren.

🤔
Think about it:

Denken Sie an das letzte KI-Projekt, an dem Sie gearbeitet haben. Wie lange hat es gedauert, bis die erste Version einem Benutzer präsentiert wurde? Hätte ein dreitägiger Sprint die Kernidee schneller validieren können?

MLOps Essentials

Produktions-ML erfordert strenge Betriebspraktiken, die die meisten Datenwissenschaftler im akademischen Umfeld nie erlernen. Das Grundprinzip ist täuschend einfach: Alles versionieren, alles automatisieren. Die Ausführung erfordert jedoch Disziplin und die richtigen Werkzeuge.

Was soll die Version sein:

  • Code - Standard-Git-Workflows
  • Daten - Verwenden Sie DVC, Delta Lake oder ähnliche Tools, um Datensatzversionen zu verfolgen
  • Modelle - Modellartefakte mit Metadaten speichern (Hyperparameter, Trainingsdaten-Hash, Bewertungsmetriken und Herkunft)
  • Konfigurationen - Umgebungsvariablen, Feature-Flags, Modellparameter und Bereitstellungskonfigurationen

Pipeline-Automatisierung:

  • Lösen Sie eine Neuschulung nach Zeitplan oder eine Datendrift-Erkennung aus
  • Automatisieren Sie die Auswertung anhand eines zurückgehaltenen Testsatzes
  • Gate-Bereitstellungen bei Leistungsschwellenwerten
  • Verwenden Sie für Modell-Rollouts blaugrüne oder kanarische Bereitstellungen
🤯

Untersuchungen von Google ergaben, dass nur etwa 5 % des realen ML-Systemcodes das tatsächliche Modell sind. Die restlichen 95 % sind Datenpipelines, die Infrastruktur, Überwachung und Konfigurationsmanagement bedienen.

MLOps-Lebenszyklus mit Daten-, Schulungs-, Bereitstellungs- und Überwachungsphasen
Der MLOps-Lebenszyklus - kontinuierliche Verbesserung, keine einmalige Bereitstellung

Überwachung: Probleme erkennen, bevor Benutzer es tun

Die Bereitstellung eines Modells ist nicht die Ziellinie, sondern der Anfang. Ohne ordnungsgemäße Überwachung verschlechtern sich Modelle geräuschlos, und wenn es jemand bemerkt, ist der Schaden bereits angerichtet.

Datendrift - Die Eingabedatenverteilung verschiebt sich im Laufe der Zeit. Ein Modell, das auf Einkaufsdaten vor der Pandemie trainiert wurde, wird bei Mustern nach der Pandemie scheitern. Überwachen Sie Merkmalsverteilungen kontinuierlich und machen Sie mit Tests wie dem Kolmogorov-Smirnov-Test oder dem Bevölkerungsstabilitätsindex auf statistisch signifikante Verschiebungen aufmerksam.

Modellverschlechterung - Auch ohne Datendrift kann die Modellleistung abnehmen, wenn sich die reale Welt ändert. Das Nutzerverhalten verändert sich, Wettbewerber verschieben den Markt und saisonale Muster verändern die Ergebnisse. Verfolgen Sie kontinuierlich die Prognosesicherheit, Fehlerraten und Geschäftskennzahlen.

Wichtige Überwachungspraktiken:

  • Protokollieren Sie alle Vorhersagen mit Eingaben, Ausgaben und Konfidenzwerten
  • Richten Sie automatische Benachrichtigungen ein, wenn die Genauigkeit unter definierte Schwellenwerte fällt
  • Vergleichen Sie die Live-Leistung mit einem Basismodell in einem rollierenden Fenster
  • Planen Sie regelmäßige menschliche Überprüfungen von Grenzfällen und Vorhersagen mit geringer Zuverlässigkeit ein
  • Verfolgen Sie Geschäftskennzahlen neben Modellkennzahlen - Genauigkeit bedeutet nichts, wenn die Conversions sinken
🧠Kurzer Check

Was ist „Datendrift” im Kontext von Produktions-ML-Systemen?

Kostenoptimierungsstrategien

Die Kosten für KI-Inferenz können schnell in die Höhe schießen. Intelligente Architekturentscheidungen sorgen dafür, dass sie beherrschbar sind.

Praktische Strategien:

  1. Route nach Komplexität - Verwenden Sie ein günstiges, schnelles Modell für einfache Abfragen und eskalieren Sie nur bei Bedarf zu teuren Modellen. Allein dadurch können die Kosten um 60-80 % gesenkt werden.
  2. Aggressiv zwischenspeichern - Wenn dieselben oder ähnliche Abfragen wiederkehren, werden die Antworten zwischengespeichert. Semantisches Caching (Übereinstimmung nach Bedeutung, nicht nach exaktem Text) ist besonders effektiv.
  3. Batch-Inferenz - Verarbeiten Sie nicht dringende Anfragen in Stapeln außerhalb der Hauptverkehrszeiten, um die GPU-Auslastung zu maximieren.
  4. Modelle quantisieren - 4-Bit- oder 8-Bit-Quantisierung kann bei den meisten Anwendungen die Kosten um 50-75 % bei minimalem Qualitätsverlust senken.
  5. Infrastruktur in der richtigen Größe - Verwenden Sie Spot-Instanzen für das Training, reservierte Instanzen für die Bereitstellung und automatische Skalierung je nach Bedarf.
🧠Kurzer Check

Bei welcher Kostenoptimierungsstrategie werden unterschiedliche Modelle basierend auf der Komplexität der Abfrage verwendet?

🤔
Think about it:

Wenn Ihnen ein Budget von 10.000 £/Monat für KI-Inferenz zur Verfügung stünde, wie würden Sie es aufteilen? Überlegen Sie, welche Teile Ihres Systems Echtzeitantworten anstelle einer Stapelverarbeitung benötigen und wo durch Caching redundante Berechnungen vermieden werden könnten.

Wichtige Erkenntnisse

Die Entwicklung von KI-Produkten ist grundsätzlich eine Produkt- und Konstruktionsherausforderung, nicht nur eine Herausforderung des maschinellen Lernens. Behalten Sie diese Grundsätze im Auge:

  • Überprüfen Sie vor dem Bau, ob KI wirklich die richtige Lösung ist
  • Passen Sie den Modelltyp an das Problem an - LLMs sind nicht immer die Lösung
  • Prototypen in Tagen, nicht Monaten, unter Verwendung bestehender Modelle und einfacher Schnittstellen
  • Versionieren Sie alles: Code, Daten, Modelle und Konfigurationen
  • Überwachen Sie Datendrift und Modellverschlechterung kontinuierlich in der Produktion
  • Optimieren Sie die Kosten durch Routing, Caching, Batching und Quantisierung

Die besten KI-Produkte werden von Teams entwickelt, die sowohl die Technologie als auch das Geschäftsproblem genau verstehen. Technische Exzellenz ohne Produktdenken führt zu beeindruckenden Demos, die niemand nutzt.