Diese Lektion wurde automatisch ins Deutsche übersetzt und noch nicht von einem Menschen geprüft. Falls etwas seltsam klingt, gilt die englische Fassung.
Jede Großanwendung besteht aus denselben Grundbausteinen. Interviewer erwarten nicht, dass Sie neue Technologien erfinden – sie möchten, dass Sie die richtigen Komponenten für ein bestimmtes Problem auswählen und kombinieren. Diese Lektion behandelt das Toolkit, nach dem Sie in jedem Design-Interview greifen werden.
Im Kern folgt das Web einem einfachen Modell: Clients senden Anfragen, Server verarbeiten sie und Antworten fließen zurück. Moderne Systeme fügen jedoch Schichten zwischen diesen beiden Endpunkten hinzu, um Skalierbarkeit, Zuverlässigkeit und Leistung zu gewährleisten.
Eine typische Anfrage könnte Folgendes durchlaufen: Client → CDN → Load Balancer → API-Gateway → Anwendungsserver → Cache → Datenbank. Jede Ebene löst ein spezifisches Problem, und wenn man weiß, wann jede Ebene benötigt wird, unterscheidet man starke Kandidaten von durchschnittlichen.
Beginnen Sie in Vorstellungsgesprächen immer damit, den groben Client-Server-Ablauf zu skizzieren, bevor Sie auf Einzelheiten eingehen. Es zeigt strukturiertes Denken.
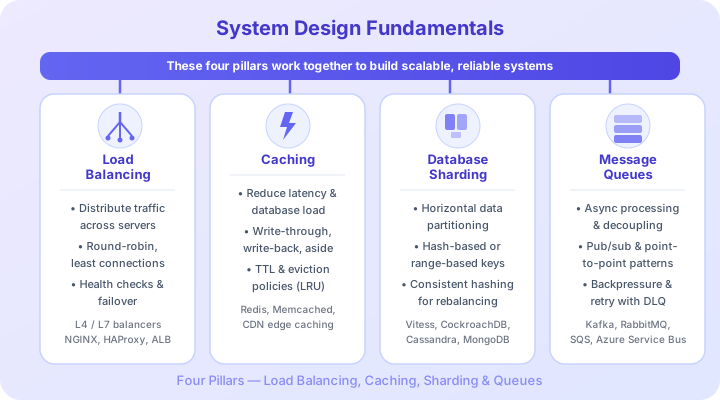
Ein einzelner Server hat eine begrenzte Kapazität. Load Balancer verteilen eingehende Anfragen auf mehrere Server und verwenden dabei Strategien wie:
Load Balancer führen auch Gesundheitsprüfungen durch und entfernen fehlerhafte Server automatisch aus dem Pool. In Cloud-Umgebungen handhaben Dienste wie AWS ALB oder Azure Front Door dies transparent.
Ein Social-Media-Feed-Dienst erhält zehnmal mehr Lese- als Schreibvorgänge. Welcher Lastausgleichsansatz stellt am besten sicher, dass Benutzer stets denselben Cache-warmen Server erreichen?
Durch Caching werden häufig aufgerufene Daten näher am Verbraucher gespeichert. Es existiert auf mehreren Ebenen:
Anmelden um an der Diskussion teilzunehmen
| Schicht | Beispiel | Latenz | |-------|---------|---------| | Browser-Cache | Statische Assets, API-Antworten | ~0ms | | CDN | Bilder, CSS, JS-Dateien | ~10-50ms | | Anwendungscache | Redis, Memcached | ~1-5ms | | Datenbank-Cache | Abfrageergebnis-Cache | ~5-10ms |
Cache-Ungültigmachung ist bekanntermaßen eines der schwierigsten Probleme im Computerbereich. Zu den gängigen Strategien gehören TTL (Time-to-Live), Write-Through (Cache bei jedem Schreibvorgang aktualisieren) und Cache-aside (Anwendung verwaltet den Cache explizit).
Phil Karltons berühmtes Zitat – „In der Informatik gibt es nur zwei schwierige Dinge: Cache-Ungültigmachung und Benennung von Dingen“ – wird so häufig zitiert, dass es in Systemdesign-Interviews praktisch ein Übergangsritus ist.
Die Wahl der richtigen Datenbank ist eine der wirkungsvollsten Designentscheidungen:
SQL-Datenbanken (PostgreSQL, MySQL) bieten ACID-Transaktionen, starke Konsistenz und strukturierte Schemata. Sie zeichnen sich aus, wenn Daten klare Beziehungen aufweisen und Sie komplexe Abfragen mit Verknüpfungen benötigen.
NoSQL-Datenbanken gibt es in verschiedenen Varianten:
Sie entwerfen ein System, das Benutzerprofile mit sich häufig ändernden, halbstrukturierten Daten (unterschiedliche Felder pro Benutzertyp) speichert. Welcher Datenbanktyp passt am besten?
Nicht jede Operation erfordert eine sofortige Reaktion. Nachrichtenwarteschlangen (RabbitMQ, Apache Kafka, AWS SQS) entkoppeln Produzenten von Konsumenten und ermöglichen Folgendes:
Kafka verdient besondere Erwähnung: Es handelt sich nicht nur um eine Warteschlange, sondern um ein verteiltes Ereignisprotokoll, das ereignisgesteuerte Architekturen ermöglicht, in denen mehrere Verbraucher unabhängig voneinander denselben Ereignisstrom verarbeiten können.
| Aspekt | Monolith | Microservices | |--------|----------|---------------| | Bereitstellung | Einzelgerät | Unabhängige Dienstleistungen | | Skalierung | Alles zusammen skalieren | Skalieren Sie einzelne Services | | Komplexität | Einfacher zu starten | Betriebsaufwand | | Daten | Gemeinsame Datenbank | Datenbank pro Dienst |
Monolith starten, Microservices bei Bedarf extrahieren. Die meisten Interviewer schätzen Kandidaten, die anerkennen, dass Microservices zu verteilter Systemkomplexität führen (Netzwerkfehler, Datenkonsistenz, Bereitstellungsorchestrierung) und nicht immer die richtige Wahl sind.
Netflix ist bekanntermaßen im Laufe mehrerer Jahre von einem Monolithen zu Mikrodiensten migriert. Aber Shopify, das Transaktionen in Milliardenhöhe abwickelt, verfügt immer noch über einen modularen Monolithen. Welche Faktoren könnten dafür sorgen, dass ein Ansatz für ein bestimmtes Unternehmen besser ist als der andere?
Das CAP-Theorem besagt, dass ein verteiltes System nur zwei von drei Eigenschaften gleichzeitig garantieren kann:
Da Netzwerkpartitionen in verteilten Systemen unvermeidlich sind, liegt die eigentliche Wahl zwischen CP (Konsistenz vor Verfügbarkeit) und AP (Verfügbarkeit vor Konsistenz).
Sie entwerfen ein Banktransaktionssystem, bei dem falsche Salden zu finanziellen Verlusten führen können. Welchen GAP-Kompromiss sollten Sie priorisieren?
Wenn Sie ein Systemdesign-Interview beginnen, befolgen Sie diese Struktur:
Denken Sie an ein System, das Sie täglich nutzen – Instagram, Uber oder Spotify. Können Sie erkennen, welche Bausteine aus dieser Lektion wahrscheinlich verwendet werden? Wo würde der Load Balancer sitzen? Was würde zwischengespeichert werden? Welcher Datenbanktyp passt zu seinem Datenmodell?
Als nächstes wenden wir diese Grundlagen an, um einen URL-Shortener von Grund auf zu entwerfen.