Matrices y mapas hash: cómo la IA almacena y recupera datos
Esta lección se tradujo automáticamente al español y aún no ha sido revisada por una persona. Si algo suena raro, la versión en inglés es la definitiva.
Por qué es importante el almacenamiento de datos en la IA
Todo sistema de IA necesita almacenar y recuperar datos rápidamente. Ya sea una lista de valores de píxeles en una imagen, un vocabulario de 50.000 palabras o millones de preferencias de usuario, la elección de la estructura de datos determina qué tan rápido puede pensar su IA.
Dominan dos estructuras: matrices y mapas hash. Si los domina, tendrá la base para casi todos los procesos de IA.
Matrices: listas ordenadas con acceso instantáneo
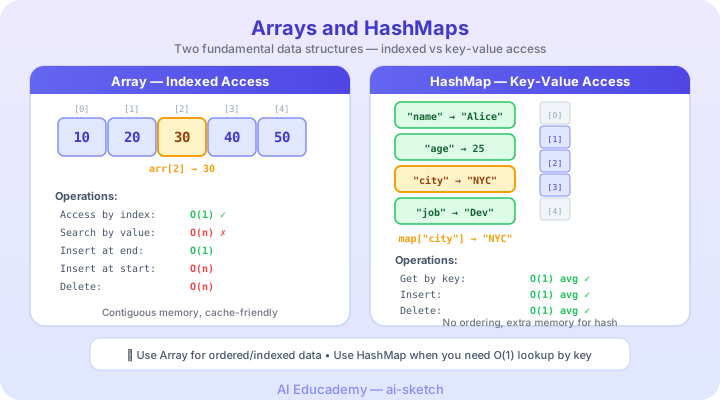
Una matriz es simplemente una lista numerada de elementos almacenados uno al lado del otro en la memoria. Cada elemento tiene un índice: su posición en la lista, comenzando desde cero.
index:   0       1       2       3       4
value: ["cat", "dog", "bird", "fish", "frog"]
Debido a que los elementos se encuentran uno al lado del otro, puedes saltar directamente a cualquier posición. ¿Quieres el artículo 3? Listo: no es necesario realizar ninguna búsqueda. Ese es el acceso O(1), lo que significa que lleva el mismo tiempo si la matriz contiene 10 elementos o 10 millones.
Cuando las matrices brillan
- Vectores de características: una imagen se puede representar como una matriz de 784 números (28×28 píxeles), cada uno con un valor de brillo.
- Incrustaciones: los modelos de lenguaje almacenan el significado de las palabras como matrices de cientos de números de punto flotante.
- Procesamiento por lotes: los datos de entrenamiento se cargan en matrices para que la GPU pueda procesar miles de ejemplos simultáneamente.
La captura
Insertar o quitar elementos en el medio es costoso. Cada elemento después del cambio debe mezclarse. Eso es O(n): cuantos más elementos, más tiempo lleva.
Si tuviera una lista de reproducción de 10,000 canciones y quisiera insertar una nueva pista en la posición 5, cada canción desde la posición 5 en adelante tendría que cambiar. ¿Cómo podría un servicio de streaming manejar esto sin disminuir la velocidad?
Mapas hash: búsquedas instantáneas por nombre
Un mapa hash (también llamado diccionario o tabla hash) almacena datos como . En lugar de acceder a los elementos por número de índice, se accede a ellos mediante una clave significativa.
Debate
Inicia sesión para unirte al debate