Visión por computadora: cómo la IA aprende a ver el mundo
Esta lección se tradujo automáticamente al español y aún no ha sido revisada por una persona. Si algo suena raro, la versión en inglés es la definitiva.
Visión por computadora: cómo la IA aprende a ver el mundo
Miras una foto y al instante sabes que muestra a un perro en la playa. Para una computadora, esa misma imagen no es más que una cuadrícula gigante de números. La visión por computadora es la rama de la IA que enseña a las máquinas a extraer significado de esos números, y ya está remodelando las industrias a su alrededor.
Cómo "ven" las computadoras
Cuando miras una fotografía, tu cerebro reconoce instantáneamente formas, colores y profundidad. una computadora no tiene nada de esa intuición. En cambio, funciona con números brutos.
Una imagen digital es una cuadrícula de píxeles. Cada píxel almacena valores de color (normalmente tres). canales: rojo, verde y azul (RGB). Una imagen HD de 1920 × 1080 contiene más de dos millones de píxeles, cada uno con tres valores que van de 0 a 255. Multiplíquelos juntos e incluso un solo cuadro contiene millones de números.
Resolución determina cuántos detalles captura la cuadrícula. Una resolución más alta significa más píxeles y detalles más ricos, pero también muchos más datos para que los procese la IA. Una imagen 4K tiene cuatro veces más píxeles de HD, lo que supone cuatro veces el coste computacional.
Las imágenes en escala de grises tienen un solo canal (brillo), mientras que algunos formatos especializados, como Imágenes satelitales o exploraciones médicas: pueden tener docenas de canales que capturan longitudes de onda invisibles. al ojo humano.
El ojo humano puede distinguir aproximadamente 10 millones de colores. Una imagen RGB estándar de 8 bits puede representar más de 16,7 millones de combinaciones de colores únicas, ¡más de las que realmente podemos percibir!
Redes neuronales convolucionales (CNN)
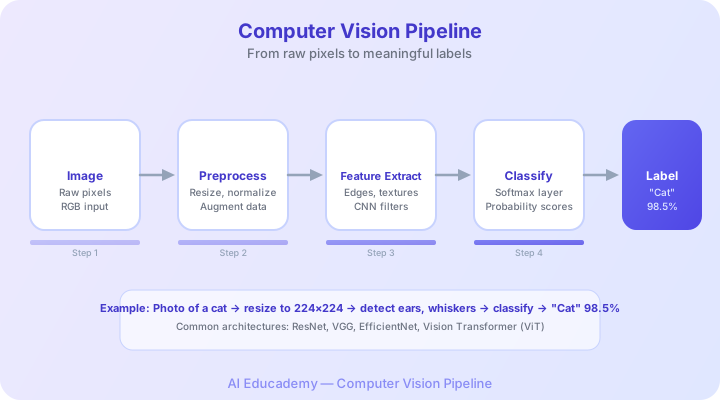
Los primeros intentos de visión por computadora se basaron en reglas hechas a mano: "busque bordes aquí, haga coincidir esto plantilla allí." Estos frágiles enfoques fracasaron cada vez que cambió la escena. Uso de sistemas modernos. Redes neuronales convolucionales (CNN), que aprenden sus propias reglas a partir de miles de redes neuronales etiquetadas. ejemplos.
Piense en una CNN como una línea de ensamblaje de detectores de patrones, en la que cada capa se basa en la anterior:
- Capas convolucionales deslizan pequeños filtros por la imagen, detectando patrones simples como Bordes, esquinas y texturas.
- reducen los datos, conservando solo las señales más importantes y descartándolas. detalle redundante.
Debate
Inicia sesión para unirte al debate