AI EducademyAIEducademy
🌳

AI-Fundamenten

🌱
AI Seeds

AI-geletterdheid voor de echte wereld

🌿
AI Sprouts

De fundamenten achter intelligente systemen

🌳
AI Branches

Bouw met de huidige AI-mogelijkheden

🏕️
AI Canopy

Ontwikkel betrouwbare GenAI-systemen

🌲
AI Forest

Verstuur AI-producten op verantwoorde wijze

🔨

AI-Meesterschap

✏️
AI Sketch

Technische basis voor AI-bouwers

🪨
AI Chisel

Patronen voor het oplossen van moeilijkere problemen

⚒️
AI Craft

Ontwerp systemen die AI schalen

💎
AI Polish

Communiceer en geef leiding in het AI-tijdperk

🏆
AI Masterpiece

Het sluitstuk van uw productie-AI

🚀

Carrière Klaar

🚀
Interview Startplatform

Navigeer door de AI-engineering-banenmarkt

🌟
Gedragsinterview Meesterschap

Vertel het verhaal over hoe jij impact creëert

💻
Technische Interviews

Oplossen, ontwerpen en communiceren onder druk

🤖
AI- & ML-interviews

Bereid je voor op moderne ML- en GenAI-interviews

🏆
Aanbod & verder

Maak een zelfverzekerde, geïnformeerde volgende stap

Alle programma's bekijken→

Laboratorium

7 experimenten geladen
🧠Neuraal netwerk speeltuin🤖AI of mens?💬Prompt-lab🎨Beeldgenerator😊Sentimentanalyse💡Chatbot bouwer⚖️Ethiek simulator
🎯Proef-sollicitatieGa het laboratorium binnen→
TrajectBloggen
🎯
Over ons

AI-onderwijs toegankelijk maken voor iedereen, overal

❓
Veelgestelde vragen

Veelgestelde vragen beantwoord

🧰
AI-tools

Zorgvuldig gekozen tools die we gebruiken en aanraden

✉️
Contacteer

Neem contact met ons op

⭐
Open source

Openbaar gebouwd op GitHub

Prijzen
Begin met leren
AI EducademyAIEducademy

© 2026 AI Educademy. Alle rechten voorbehouden.

Leren

  • Opleidingen
  • Lessen
  • Laboratorium
  • AI-starterskit
  • Prijzen

Gemeenschap

  • GitHub
  • Bijdragen
  • Gedragscode
  • Over ons
  • Veelgestelde vragen

Ondersteuning

  • Koop een koffie voor me ☕
  • Servicevoorwaarden
  • Privacybeleid
  • Contacteer
  • Sitemap
AI & Engineering Opleidingen›🌿 AI Sprouts›Lessen›Datasets en Data - De Brandstof van AI
📊
AI Sprouts • Beginnerniveau⏱️ 12 min leestijd

Datasets en Data - De Brandstof van AI

Welkom bij Niveau 2! 👋

In AI Seeds heb je geleerd dat AI leert van voorbeelden - net als een kind dat dieren leert herkennen uit prentenboeken. Maar waar komen die voorbeelden vandaan?

Het antwoord is data - en het is het allerbelangrijkste ingrediënt in AI. Slechte data leidt tot slechte AI. Geweldige data leidt tot geweldige AI.
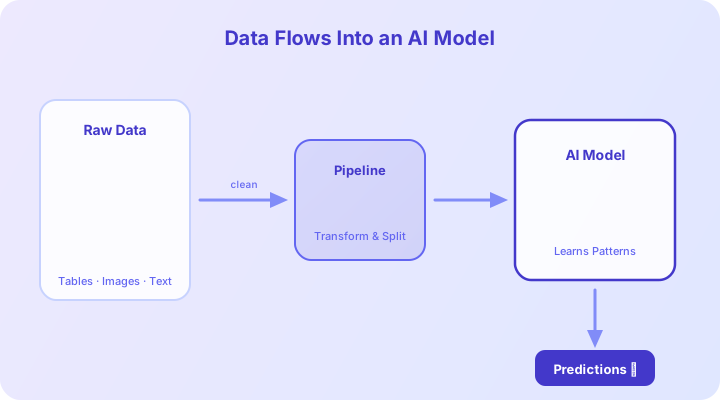
Data stroomt in een AI-model zoals brandstof in een motor
Data is de brandstof die elk AI-systeem aandrijft

Wat is Data? 🤔

Data is simpelweg vastgelegde informatie. Elke digitale actie creëert data:

  • 📸 Een foto maken → beelddata
  • 💬 Een bericht sturen → tekstdata
  • 🎵 Een nummer afspelen → luistergeschiedenis
  • 🛒 Online iets kopen → transactiedata
  • 📍 Google Maps openen → locatiedata

In AI verzamelen we deze informatie, organiseren we het en gebruiken we het om machines te leren.


Gestructureerde vs Ongestructureerde Data

📋 Gestructureerde Data

Data die netjes in rijen en kolommen past - zoals een spreadsheet.

| Naam | Leeftijd | Stad | Lievelingskleur | |------|----------|------|-----------------| | Aisha | 14 | Londen | Blauw | | Ravi | 16 | Hyderabad | Groen | | Emma | 15 | Amsterdam | Rood |

🖼️ Ongestructureerde Data

Data die niet in een tabel past - afbeeldingen, video's, audio, e-mails, social media posts.

🤯

Meer dan 80% van alle data wereldwijd is ongestructureerd! Foto's, video's en berichten overtreffen spreadsheets ruimschoots. Modern deep learning is speciaal ontworpen om deze rommelige data te verwerken.


Trainings-, Validatie- en Testdata

Als je voor een examen studeert, lees je niet alleen het boek - je oefent ook met proefvragen en doet dan het echte examen. AI doet hetzelfde met drie datasplits:

📚 Trainingsdata (het studieboek)

Het grootste deel - 70 tot 80% van alle data. Het AI-model bestudeert dit om patronen te leren.

📝 Validatiedata (oefenvragen)

Ongeveer 10 tot 15%. Gebruikt tijdens het trainen om voortgang te controleren.

🎓 Testdata (het eindexamen)

De overige 10 tot 15%. Gebruikt na het trainen. Het model heeft deze data nooit eerder gezien.

from sklearn.model_selection import train_test_split

# Split: 80% training, 20% tijdelijk
train_data, temp_data = train_test_split(all_data, test_size=0.2)

# Split tijdelijke set: helft validatie, helft test
val_data, test_data = train_test_split(temp_data, test_size=0.5)

print(f"Training: {len(train_data)}")
print(f"Validatie: {len(val_data)}")
print(f"Test: {len(test_data)}")
Les 1 van 160% voltooid
←Terug naar programma
Verdergaan: Algoritmen Uitgelegd - De Recepten van AI→

Discussie

Meld je aan om deel te nemen aan de discussie

Stel een wijziging voor deze les voor
🤔
Think about it:

Waarom kunnen we het model niet gewoon testen op dezelfde data waarop het getraind is? Omdat het dan zou zijn alsof je een student de exacte examenvragen van tevoren geeft - perfecte score maar misschien geen echt begrip.


Databias - Waarom Het Belangrijk Is ⚖️

AI is slechts zo eerlijk als de data waarvan het leert.

Als je een gezichtsherkenningssysteem voornamelijk traint op foto's van mensen met een lichte huid, zal het slecht presteren op donkerdere gezichten.

Voorbeelden van databias:

  • 🏥 Medische AI voornamelijk getraind op mannendata - verkeerde diagnoses bij vrouwen
  • 💼 Wervings-AI getraind op historische cv's - benadeling van vrouwelijke kandidaten
  • 🚗 Zelfrijdende auto's getraind in zonnig Californië - problemen met regen en sneeuw
💡

Bias is niet altijd zichtbaar. Als je dataset 90% Engelse tekst bevat, zal je AI uitstekend zijn in Engels maar slecht in Hindi, Telugu of Nederlands. Vraag altijd: "Wie ontbreekt in deze data?"


Beroemde Datasets 🌍

✍️ MNIST

  • Wat: 70.000 afbeeldingen van handgeschreven cijfers (0–9)
  • Belang: Het "Hello World" van machine learning

🖼️ ImageNet

  • Wat: Meer dan 14 miljoen gelabelde afbeeldingen in meer dan 20.000 categorieën
  • Belang: De ImageNet-competitie (2010–2017) dreef enorme verbeteringen in beeldherkenning

🌐 Common Crawl

  • Wat: Petabytes aan webpagina-data verzameld sinds 2008
  • Belang: Dit is wat grote taalmodellen zoals GPT aandrijft

🗣️ LibriSpeech

  • Wat: 1.000 uur voorgelezen Engelstalige spraak
  • Belang: Gebruikt om spraakherkenningssystemen te trainen
🤯

De hele MNIST-dataset is minder dan 15 MB - kleiner dan één smartphonefoto! Toch heeft het duizenden AI-carrières gelanceerd.


Praktijk: Een Dataset Verkennen 🔬

Laten we de beroemde Iris-dataset verkennen - 150 metingen van bloemen met 4 kenmerken.

import pandas as pd
from sklearn.datasets import load_iris

# Dataset laden
iris = load_iris()
df = pd.DataFrame(iris.data, columns=iris.feature_names)
df['species'] = [iris.target_names[t] for t in iris.target]

# Basisverkenning
print("Vorm:", df.shape)
print("\nEerste 5 rijen:")
print(df.head())

print("\nAantal per soort:")
print(df['species'].value_counts())

print("\nBasisstatistieken:")
print(df.describe())

Bij het verkennen van een dataset, vraag altijd:

  1. Hoeveel samples? (rijen)
  2. Hoeveel kenmerken? (kolommen)
  3. Zijn de klassen gebalanceerd?
  4. Zijn er ontbrekende waarden?
  5. Hoe zien de getallen eruit? (bereik, gemiddelde, spreiding)

Snelle Samenvatting 🎯

  1. Data is vastgelegde informatie - foto's, berichten, klikken
  2. Gestructureerde data past in tabellen; ongestructureerde data (afbeeldingen, tekst, audio) niet
  3. Data wordt gesplitst in training (leren), validatie (afstemmen) en test (evalueren)
  4. Databias leidt tot oneerlijke AI - vraag altijd wie ontbreekt
  5. Datasets zoals MNIST, ImageNet en Common Crawl drijven huidige AI aan
  6. Verken altijd je data voordat je een model bouwt

Wat Komt Er Volgende? 🚀

Je weet nu wat AI aandrijft. In de volgende les verkennen we algoritmen - de stapsgewijze recepten die data omzetten in intelligente beslissingen!