AI EducademyAIEducademy
🌳

AI-Fundamenten

🌱
AI Seeds

AI-geletterdheid voor de echte wereld

🌿
AI Sprouts

De fundamenten achter intelligente systemen

🌳
AI Branches

Bouw met de huidige AI-mogelijkheden

🏕️
AI Canopy

Ontwikkel betrouwbare GenAI-systemen

🌲
AI Forest

Verstuur AI-producten op verantwoorde wijze

🔨

AI-Meesterschap

✏️
AI Sketch

Technische basis voor AI-bouwers

🪨
AI Chisel

Patronen voor het oplossen van moeilijkere problemen

⚒️
AI Craft

Ontwerp systemen die AI schalen

💎
AI Polish

Communiceer en geef leiding in het AI-tijdperk

🏆
AI Masterpiece

Het sluitstuk van uw productie-AI

🚀

Carrière Klaar

🚀
Interview Startplatform

Navigeer door de AI-engineering-banenmarkt

🌟
Gedragsinterview Meesterschap

Vertel het verhaal over hoe jij impact creëert

💻
Technische Interviews

Oplossen, ontwerpen en communiceren onder druk

🤖
AI- & ML-interviews

Bereid je voor op moderne ML- en GenAI-interviews

🏆
Aanbod & verder

Maak een zelfverzekerde, geïnformeerde volgende stap

Alle programma's bekijken→

Laboratorium

7 experimenten geladen
🧠Neuraal netwerk speeltuin🤖AI of mens?💬Prompt-lab🎨Beeldgenerator😊Sentimentanalyse💡Chatbot bouwer⚖️Ethiek simulator
🎯Proef-sollicitatieGa het laboratorium binnen→
TrajectBloggen
🎯
Over ons

AI-onderwijs toegankelijk maken voor iedereen, overal

❓
Veelgestelde vragen

Veelgestelde vragen beantwoord

🧰
AI-tools

Zorgvuldig gekozen tools die we gebruiken en aanraden

✉️
Contacteer

Neem contact met ons op

⭐
Open source

Openbaar gebouwd op GitHub

Prijzen
Begin met leren
AI EducademyAIEducademy

© 2026 AI Educademy. Alle rechten voorbehouden.

Leren

  • Opleidingen
  • Lessen
  • Laboratorium
  • AI-starterskit
  • Prijzen

Gemeenschap

  • GitHub
  • Bijdragen
  • Gedragscode
  • Over ons
  • Veelgestelde vragen

Ondersteuning

  • Koop een koffie voor me ☕
  • Servicevoorwaarden
  • Privacybeleid
  • Contacteer
  • Sitemap
AI & Engineering Opleidingen›✏️ AI Sketch›Lessen›Arrays en Hash Maps - Hoe AI Data Opslaat en Ophaalt
📦
AI Sketch • Gemiddeld⏱️ 15 min leestijd

Arrays en Hash Maps - Hoe AI Data Opslaat en Ophaalt

Waarom Dataopslag Belangrijk Is in AI

Elk AI-systeem moet data opslaan en snel terugvinden. Of het nu gaat om pixelwaarden in een afbeelding, een vocabulaire van 50.000 woorden of miljoenen gebruikersvoorkeuren - de keuze van datastructuur bepaalt hoe snel je AI kan denken.

Twee structuren domineren: arrays en hash maps. Beheers deze twee en je hebt de basis voor vrijwel elke AI-pipeline.

Arrays - Geordende Lijsten met Directe Toegang

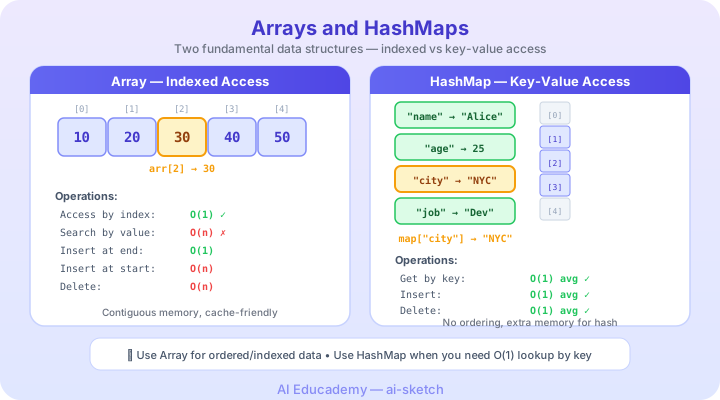
Een array is simpelweg een genummerde lijst van items die naast elkaar in het geheugen staan. Elk item heeft een index - zijn positie in de lijst, beginnend bij nul.

index:   0       1       2       3       4
value: ["cat", "dog", "bird", "fish", "frog"]

Omdat items naast elkaar staan, kun je direct naar elke positie springen. Item 3 nodig? Klaar - geen zoekwerk vereist. Dat is O(1) toegang: het kost evenveel tijd of de array nu 10 of 10 miljoen items bevat.
Een array van vijf elementen met indices 0 tot en met 4, met directe toegang tot index 3
Met arrays spring je direct naar elke positie via de index.

Wanneer Arrays Uitblinken

  • Feature vectors: Een afbeelding kan worden voorgesteld als een array van 784 getallen (28×28 pixels), elk met een helderheidswaarde.
  • Embeddings: Taalmodellen slaan woordbetekenissen op als arrays van honderden floating-point getallen.
  • Batchverwerking: Trainingsdata wordt in arrays geladen zodat de GPU duizenden voorbeelden tegelijk kan verwerken.

Het Nadeel

Invoegen of verwijderen in het midden is duur. Elk item na de wijziging moet opschuiven. Dat is O(n) - hoe meer items, hoe langer het duurt.

🤔
Think about it:

Stel je hebt een playlist van 10.000 nummers en je wilt een nieuw nummer invoegen op positie 5. Elk nummer vanaf positie 5 moet opschuiven. Hoe zou een streamingdienst dit aanpakken zonder traag te worden?

Hash Maps - Direct Opzoeken op Naam

Een hash map (ook wel dictionary of hash table genoemd) slaat data op als key-value paren. In plaats van toegang via een indexnummer, gebruik je een betekenisvolle sleutel.

word_counts = {
  "hello": 42,
  "world": 37,
  "AI": 156
}
Les 1 van 100% voltooid
←Terug naar programma
Verdergaan: Strings en Tekstverwerking - Hoe AI Tekst Leest en Begrijpt→

Discussie

Meld je aan om deel te nemen aan de discussie

Stel een wijziging voor deze les voor

De telling van "AI" nodig? De hash map gebruikt een hash function om de sleutel achter de schermen om te zetten naar een index. Het resultaat? Gemiddeld O(1) opzoektijd - net als arrays, maar dan met namen in plaats van nummers.

🤯

Python's dictionaries zijn hash maps. Wanneer ChatGPT woordfrequenties telt tijdens training, gebruikt het hash-map-achtige structuren om miljarden woordvoorkomens bij te houden uit alle tekst op het internet.

Hash Maps in AI

  • Vocabulaire-mapping: Woorden als "brilliant" omzetten naar token-ID 8921 voor een taalmodel.
  • Frequenties tellen: Hoe vaak komt elk woord voor in een dataset? Hash maps beantwoorden dit in één doorgang.
  • Resultaten cachen: Als een AI al een voorspelling heeft berekend voor input X, sla die dan op zodat je nooit opnieuw hoeft te rekenen.

Tijdscomplexiteit Eenvoudig Uitgelegd

| Operatie | Array | Hash Map | |----------|-------|----------| | Toegang via index | O(1) ⚡ | N/A | | Toegang via sleutel | O(n) 🐢 | O(1) ⚡ | | Invoegen aan het einde | O(1) ⚡ | O(1) ⚡ | | Invoegen in het midden | O(n) 🐢 | N/A | | Zoeken naar waarde | O(n) 🐢 | O(1) ⚡ |

Zie O(1) als "instant, ongeacht de grootte" en O(n) als "trager naarmate de data groter wordt."

🧠Snelle check

Je hebt 100.000 gebruikersprofielen en moet een gebruiker vinden op gebruikersnaam. Welke structuur is het snelst?

Veelvoorkomend Patroon: Frequenties Tellen

Een van de meest bruikbare patronen in zowel interviews als AI is het tellen van voorkomens:

counts = {}
for each word in text:
    if word in counts:
        counts[word] = counts[word] + 1
    else:
        counts[word] = 1

Eén doorgang door de tekst geeft je de frequentie van elk woord. Taalmodellen gebruiken precies deze aanpak (op enorme schaal) om te begrijpen welke woorden het belangrijkst zijn.

Veelvoorkomend Patroon: Het Two-Sum Probleem

Gegeven een array van getallen en een doelwaarde: vind twee getallen die samen de doelwaarde vormen. De naïeve aanpak controleert elk paar - O(n²). De slimme aanpak gebruikt een hash map:

seen = {}
for each number in array:
    complement = target - number
    if complement in seen:
        return [seen[complement], current_index]
    seen[number] = current_index

Eén doorgang, O(n) tijd. De hash map onthoudt wat je al gezien hebt.

🧠Snelle check

Waarom is de hash map-aanpak voor two-sum sneller dan elk paar controleren?

Wanneer Kies Je Wat

  • Gebruik arrays als volgorde belangrijk is, je items op positie benadert, of alles sequentieel moet verwerken (zoals pixels in een afbeelding).
  • Gebruik hash maps als je snel op sleutel wilt opzoeken, voorkomens wilt tellen, of snel wilt checken of iets bestaat.
🤔
Think about it:

Een aanbevelingssysteem moet controleren of een gebruiker een film al heeft gezien voordat het die aanraadt. Zou je de kijkgeschiedenis opslaan in een array of een hash map? Welke afwegingen spelen mee?

🧠Snelle check

Een AI-model slaat word embeddings op als arrays van 300 getallen. Waarom zijn arrays hier een goede keuze?

Belangrijkste Inzichten

  • Arrays bieden O(1) toegang via index en vormen de ruggengraat van numerieke AI (afbeeldingen, embeddings, tensors).
  • Hash maps bieden O(1) toegang via sleutel en zijn essentieel voor lookups, tellen en caching.
  • De juiste structuur kiezen kan een O(n²)-algoritme omzetten in O(n) - een verschil dat ertoe doet bij miljoenen datapunten.
  • In de praktijk gebruiken de meeste AI-pipelines beide: arrays voor numerieke berekeningen en hash maps voor metadata-lookups.

Wat komt hierna?

Je kent nu de twee werkpaarden van gegevensverwerking in AI. Hierna zien we in Strings en Tekstverwerking hoe AI ruwe tekst omzet in iets wat een model echt kan lezen: de eerste stap achter elke chatbot en elk zoekvak dat je gebruikt.