AI-producten Bouwen - Van Prototype tot Productie
De Levenscyclus van een AI-Product 🏭
Je hebt geleerd hoe AI werkt - data, algoritmen, neurale netwerken, transformers en tools. Nu is het tijd om alles samen te brengen en iets echts te bouwen.
Het bouwen van een AI-product verschilt fundamenteel van het bouwen van traditionele software. Modellen degraderen, data drifteert, en wat werkt in een notebook faalt vaak in productie.
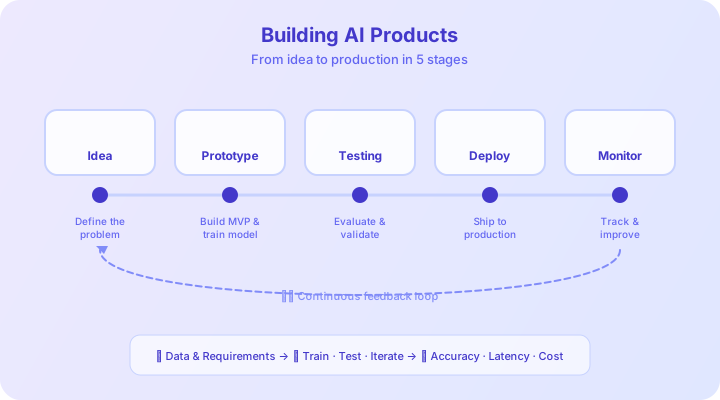
Fase 1: Probleemdefinitie en Haalbaarheid 🎯
- Is AI echt nodig? Veel problemen zijn beter op te lossen met regels of eenvoudige statistieken
- Heb je de data? AI is slechts zo goed als de data waarvan het leert
- Hoe ziet succes eruit? Definieer meetbare metrics vooraf
- Wat zijn de risico's? Valse positieven vs valse negatieven - wat is erger?
Beslissingskader: Moet Je AI Gebruiken?
──────────────────────────────────────────
✅ Gebruik AI wanneer:
   • Het patroon te complex is voor handgeschreven regels
   • Je voldoende gelabelde data hebt
   • Het probleem een zeker foutenniveau tolereert

❌ Sla AI over wanneer:
   • Eenvoudige regels het probleem oplossen
   • Je 100% nauwkeurigheid nodig hebt
   • Data schaars is
Een groot retailbedrijf besteedde miljoenen aan een AI-aanbevelingsengine, om te ontdekken dat een eenvoudige "klanten kochten ook"-tabel bijna even goed presteerde. Begin altijd met de eenvoudigste oplossing die zou kunnen werken.
Fase 2: Het Juiste Model Kiezen 🧩
Traditionele ML - Tabeldata, interpreteerbaarheid, beperkte data
Deep Learning - Beelden, audio, video, tekst, grote datasets
Grote Taalmodellen - Tekstgeneratie, samenvatting, Q&A, snel prototypen
Voorgetrainde API's - Standaardtaken, snelle integratie
def kies_model(probleem):
    if probleem.data_type == "tabel":
        return "XGBoost of Random Forest"
    if probleem.data_type in ["beeld", "audio", "video"]:
        return "Verfijn een voorgetraind model"
    if probleem.data_type == "tekst":
        if probleem.taak == "generatie":
            return "LLM (GPT, Claude, Llama)"
        return "Verfijnd BERT of Sentence Transformers"
    return "Begin eenvoudig, itereer"
Discussie
Meld je aan om deel te nemen aan de discussie