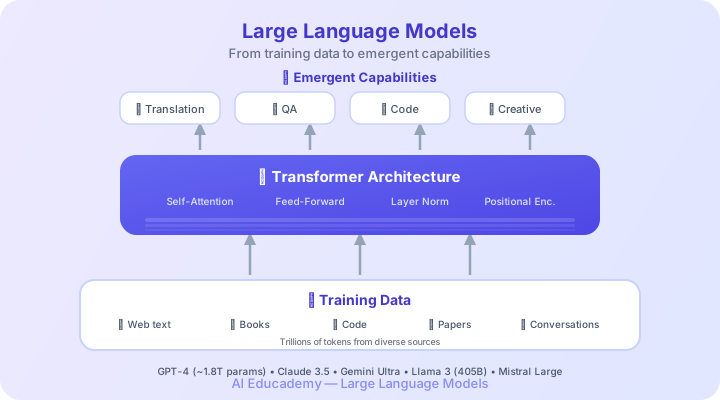
Grote taalmodellen hebben fundamenteel veranderd wat machines met tekst, code en redeneren kunnen doen. In deze les kijken we achter de schermen: hoe ze werken, waarom ze zo krachtig zijn en waar ze nog tekortschieten.
Een groot taalmodel is een neuraal netwerk dat op enorme hoeveelheden tekst is getraind om het volgende token in een reeks te voorspellen. "Groot" verwijst naar het aantal parameters: leerbare gewichten die patronen uit trainingsdata vastleggen.
Deze modellen worden getraind op honderden miljarden woorden uit boeken, websites, code-repositories en academische papers. De enorme schaal van data en parameters geeft LLM's hun opmerkelijke veelzijdigheid.
Tokens, geen woorden: LLM's verwerken geen volledige woorden. Ze werken met tokens, eenheden die kleiner zijn dan woorden. Het woord "understanding" kan bijvoorbeeld worden gesplitst in "under" + "stand" + "ing". Een gemiddeld Engels woord is ongeveer 1,3 token. Deze tokenisatie helpt modellen zeldzame woorden, technisch jargon en zelfs meerdere talen te verwerken zonder een onmogelijk grote woordenschat.
Het trainen van een frontier-taalmodel kan honderden miljoenen kosten aan rekenkracht, data, energie en engineering. Dat is ongeveer het budget van een grote film, behalve dat de "acteur" elke programmeertaal kan spreken.
Elk modern LLM is gebouwd op de Transformer, geïntroduceerd in het paper uit 2017 Attention Is All You Need. De kerninnovatie is self-attention, een mechanisme waarmee het model weegt hoe belangrijk elk woord is ten opzichte van elk ander woord in de invoer.
Hoe self-attention werkt (vereenvoudigd):
Meld je aan om deel te nemen aan de discussie
De wiskundige formule in het hart van attention is:
Attention(Q, K, V) = softmax(QK^T / √d) × V
De deling door √d (de vierkantswortel van de key-dimensie) voorkomt dat de dotproducten te groot worden, waardoor de softmax-functie in gebieden met extreem kleine gradiënten terecht zou komen. Deze eenvoudige schaaltruc was een van de belangrijkste inzichten die het trainen van diepe Transformers stabiel maakte.
Dit wordt parallel herhaald over meerdere attention heads, waardoor het model tegelijk verschillende soorten relaties kan vastleggen, bijvoorbeeld syntaxis in de ene head en semantiek in een andere.
Als een zin 500 tokens heeft, vergelijkt self-attention elk token met elk ander token. Dat zijn 250.000 vergelijkingen per laag. Welk effect kan deze kwadratische kost hebben op wat LLM's kunnen verwerken?
| Model | Maker | Opvallende eigenschap | |-------|---------|-----------------| | GPT-6 Astra | OpenAI | Frontier-redeneren, coderen, onderzoek en multimodale invoer | | Claude Opus 5.5 | Anthropic | Langlopende agentische codering en kenniswerk | | Gemini 3.1 Pro | Google DeepMind | Geavanceerd redeneren, coderen en multimodaliteit | | Llama 4 | Meta | Open gewichten, native multimodaliteit, lange context | | Mistral Large | Mistral AI | Efficiënt Europees alternatief |
Het vakgebied beweegt buitengewoon snel. Tegen de tijd dat je dit leest, kunnen er alweer nieuwere modellen bestaan.
Een cruciaal onderscheid in dit landschap is dat tussen gesloten modellen (GPT, Claude, Gemini), waarbij alleen de API beschikbaar is, en open-weight modellen (Llama, Mistral), waarbij de modelgewichten openbaar zijn vrijgegeven. Open-weight modellen laten organisaties inferentie draaien op hun eigen infrastructuur, fine-tunen voor specifieke domeinen en het gedrag van het model inspecteren, voordelen die bijzonder belangrijk zijn voor privacygevoelige sectoren.
Niet alle "open" modellen zijn echt open source. Sommige geven gewichten vrij, maar beperken commercieel gebruik of delen de trainingsdata en code niet. Controleer altijd de licentie voordat je een open-weight model in productie inzet.
LLM's worden in fases gebouwd:
Pre-training - Het model leest enorme hoeveelheden tekst en leert het volgende token te voorspellen. Deze fase is extreem duur en levert een basismodel op dat tekst kan aanvullen, maar nog niet bijzonder behulpzaam is.
Supervised fine-tuning (SFT) - Door mensen geschreven voorbeelden van ideale antwoorden leren het model instructies volgen en vragen goed beantwoorden.
RLHF (Reinforcement Learning from Human Feedback) - Menselijke beoordelaars rangschikken modeluitvoer van best naar slechtst. Een reward model leert deze voorkeuren, waarna het LLM wordt getraind om de beloning te maximaliseren. Dit maakt modellen behulpzaam, onschadelijk en eerlijk.
Wat is het primaire doel van RLHF in LLM-training?
Naarmate modellen groter worden, ontwikkelen ze vaardigheden waarvoor ze niet expliciet zijn getraind:
Deze emergente eigenschappen zijn een van de fascinerendste aspecten van schaalvergroting: vaardigheden die bijna "gratis" lijken te verschijnen zodra een model bepaalde groottedrempels overschrijdt.
Vroege frontier-modellen lieten het patroon duidelijk zien: ze konden moeilijke beroepsexamens halen, maar struikelden nog steeds over eenvoudige reken- of teltaken wanneer de prompt hun zwaktes blootlegde.
LLM's zijn krachtig, maar verre van perfect:
Controleer kritieke feiten uit LLM-uitvoer altijd bij gezaghebbende bronnen. Behandel LLM's als een briljante maar onbetrouwbare onderzoeksassistent: buitengewoon nuttig, maar nooit het laatste woord over feitelijke zaken.
Waarom produceren LLM's soms hallucinaties?
Jarenlang was de dominante overtuiging dat groter altijd beter is: meer parameters, meer data en meer rekenkracht zouden de prestaties gestaag verbeteren. Deze "scaling law" hield opmerkelijk goed stand gedurende de GPT-2-, GPT-3- en GPT-4-generatie en latere frontier-systemen.
Recent onderzoek suggereert echter dat we mogelijk afnemende meeropbrengsten bereiken met ruwe schaal alleen. De focus verschuift naar:
Grote taalmodellen vormen een echte paradigmaverschuiving in computing. Hun architectuur, trainingspijplijn en beperkingen begrijpen is niet optioneel voor wie serieus met AI werkt. Het is basiskennis die je goed van pas komt terwijl het vakgebied zich blijft ontwikkelen.
Welke fase van LLM-training is computationeel het duurst?
Als een LLM het balie-examen kan halen, maar niet betrouwbaar het aantal letters in een woord kan tellen, wat zegt dat dan over het verschil tussen menselijke intelligentie en de mogelijkheden van taalmodellen?